“北极星”基础教育大模型评测场四期评测榜单发布
在市教委指导和市科委支持下,北京师范大学智能技术与教育应用教育部工程研究中心、教育人工智能北京市重点实验室,联合北京教育科学研究院和北京智源人工智能研究院共建“北极星”基础教育大模型评测场(www.bnueval.com),具备紧扣新课标、聚焦教育应用、多学科多场景的特点,是首个基础教育领域的大模型评测场。
继2025年6月、2025年10月和2026年6月前三期榜单发布后,“北极星”评测场于2026年10月面向多款近期发布或升级的大模型开展新一轮评测,发布并解读智能解题、智能答疑、智能出题、教案生成、口语练习、作文批改6大场景的评测结果。
本期评测榜单由北京市数字教育中心资助,评测主要分析结果如下。
1.参评模型在教育多场景中表现持续提升,多项此前薄弱维度得到改善,部分场景中模型间差距缩小。在智能解题中,模型的主观题、推理计算型题与多模态有图题的得分提高,主观题与客观题、有图题与无图题的差距缩小;在智能答疑中,模型整体得分提升,对学生的合理反馈与启发引导质量增强;在智能出题中,模型的约束满足度、解析准确性与素养导向性得分均提升明显;在教案生成中,模型保持高水平组织能力,数理化三科的内容准确性与素养导向性改善;在口语练习中,模型基础表达稳定、听力理解提升,国产模型语音输出具备优势;在作文批改中,模型对低分段作文的批改表现提升,各分数段批改差距缩小。
2.参评模型在深层教育场景中的能力仍存短板。在智能解题中,模型主观题得分依然低于客观题得分,操作表达型题得分低于记忆识别型和推理计算型得分,有图题得分普遍低于无图题得分;在智能答疑中,面对学生偏题的话题导正与复杂问题分步讲解仍是最大瓶颈;在智能出题中,素养导向性依然偏低,对逻辑链式、错误路线等高阶命题约束满足不足;在教案生成中,模型在学科间表现不均衡,内容准确性仍是主要短板;在口语练习中,模型的交互质量有待提升,且涉及韵律、情绪与场景的深层听力理解能力依然不足;在作文批改中,模型仍存在“低分高估、高分低估”现象,评分尺度校准、上下文细粒度纠错及手写图片识别纠错能力依然薄弱。
各场景深层洞察分析结果如下,完整榜单请登录官网查看(www.bnueval.com)。
教育专业能力评测聚焦初中解题场景,覆盖语文、数学、英语、物理、化学、生物、历史、地理 8大核心学科,包含客观题和主观题,依据新课标课程内容制定每门学科的细粒度评测维度,详细评测结果见附件,从评测结果中得到以下观察。
(1)本期参评模型的主观题得分依然低于客观题得分,主客观题得分差距明显缩小。本期参评模型的客观题、主观题平均得分分别为96.54分和94.90分,相较于三期的94.10分和85.88分,分别提升2.44分和9.02分;主客观题平均差距由三期的8.22分缩小至本期的1.64分。尽管模型主观题解题表现提升突出,当前主观题作答能力依然相对薄弱,答案组织与步骤完整性有待提升。
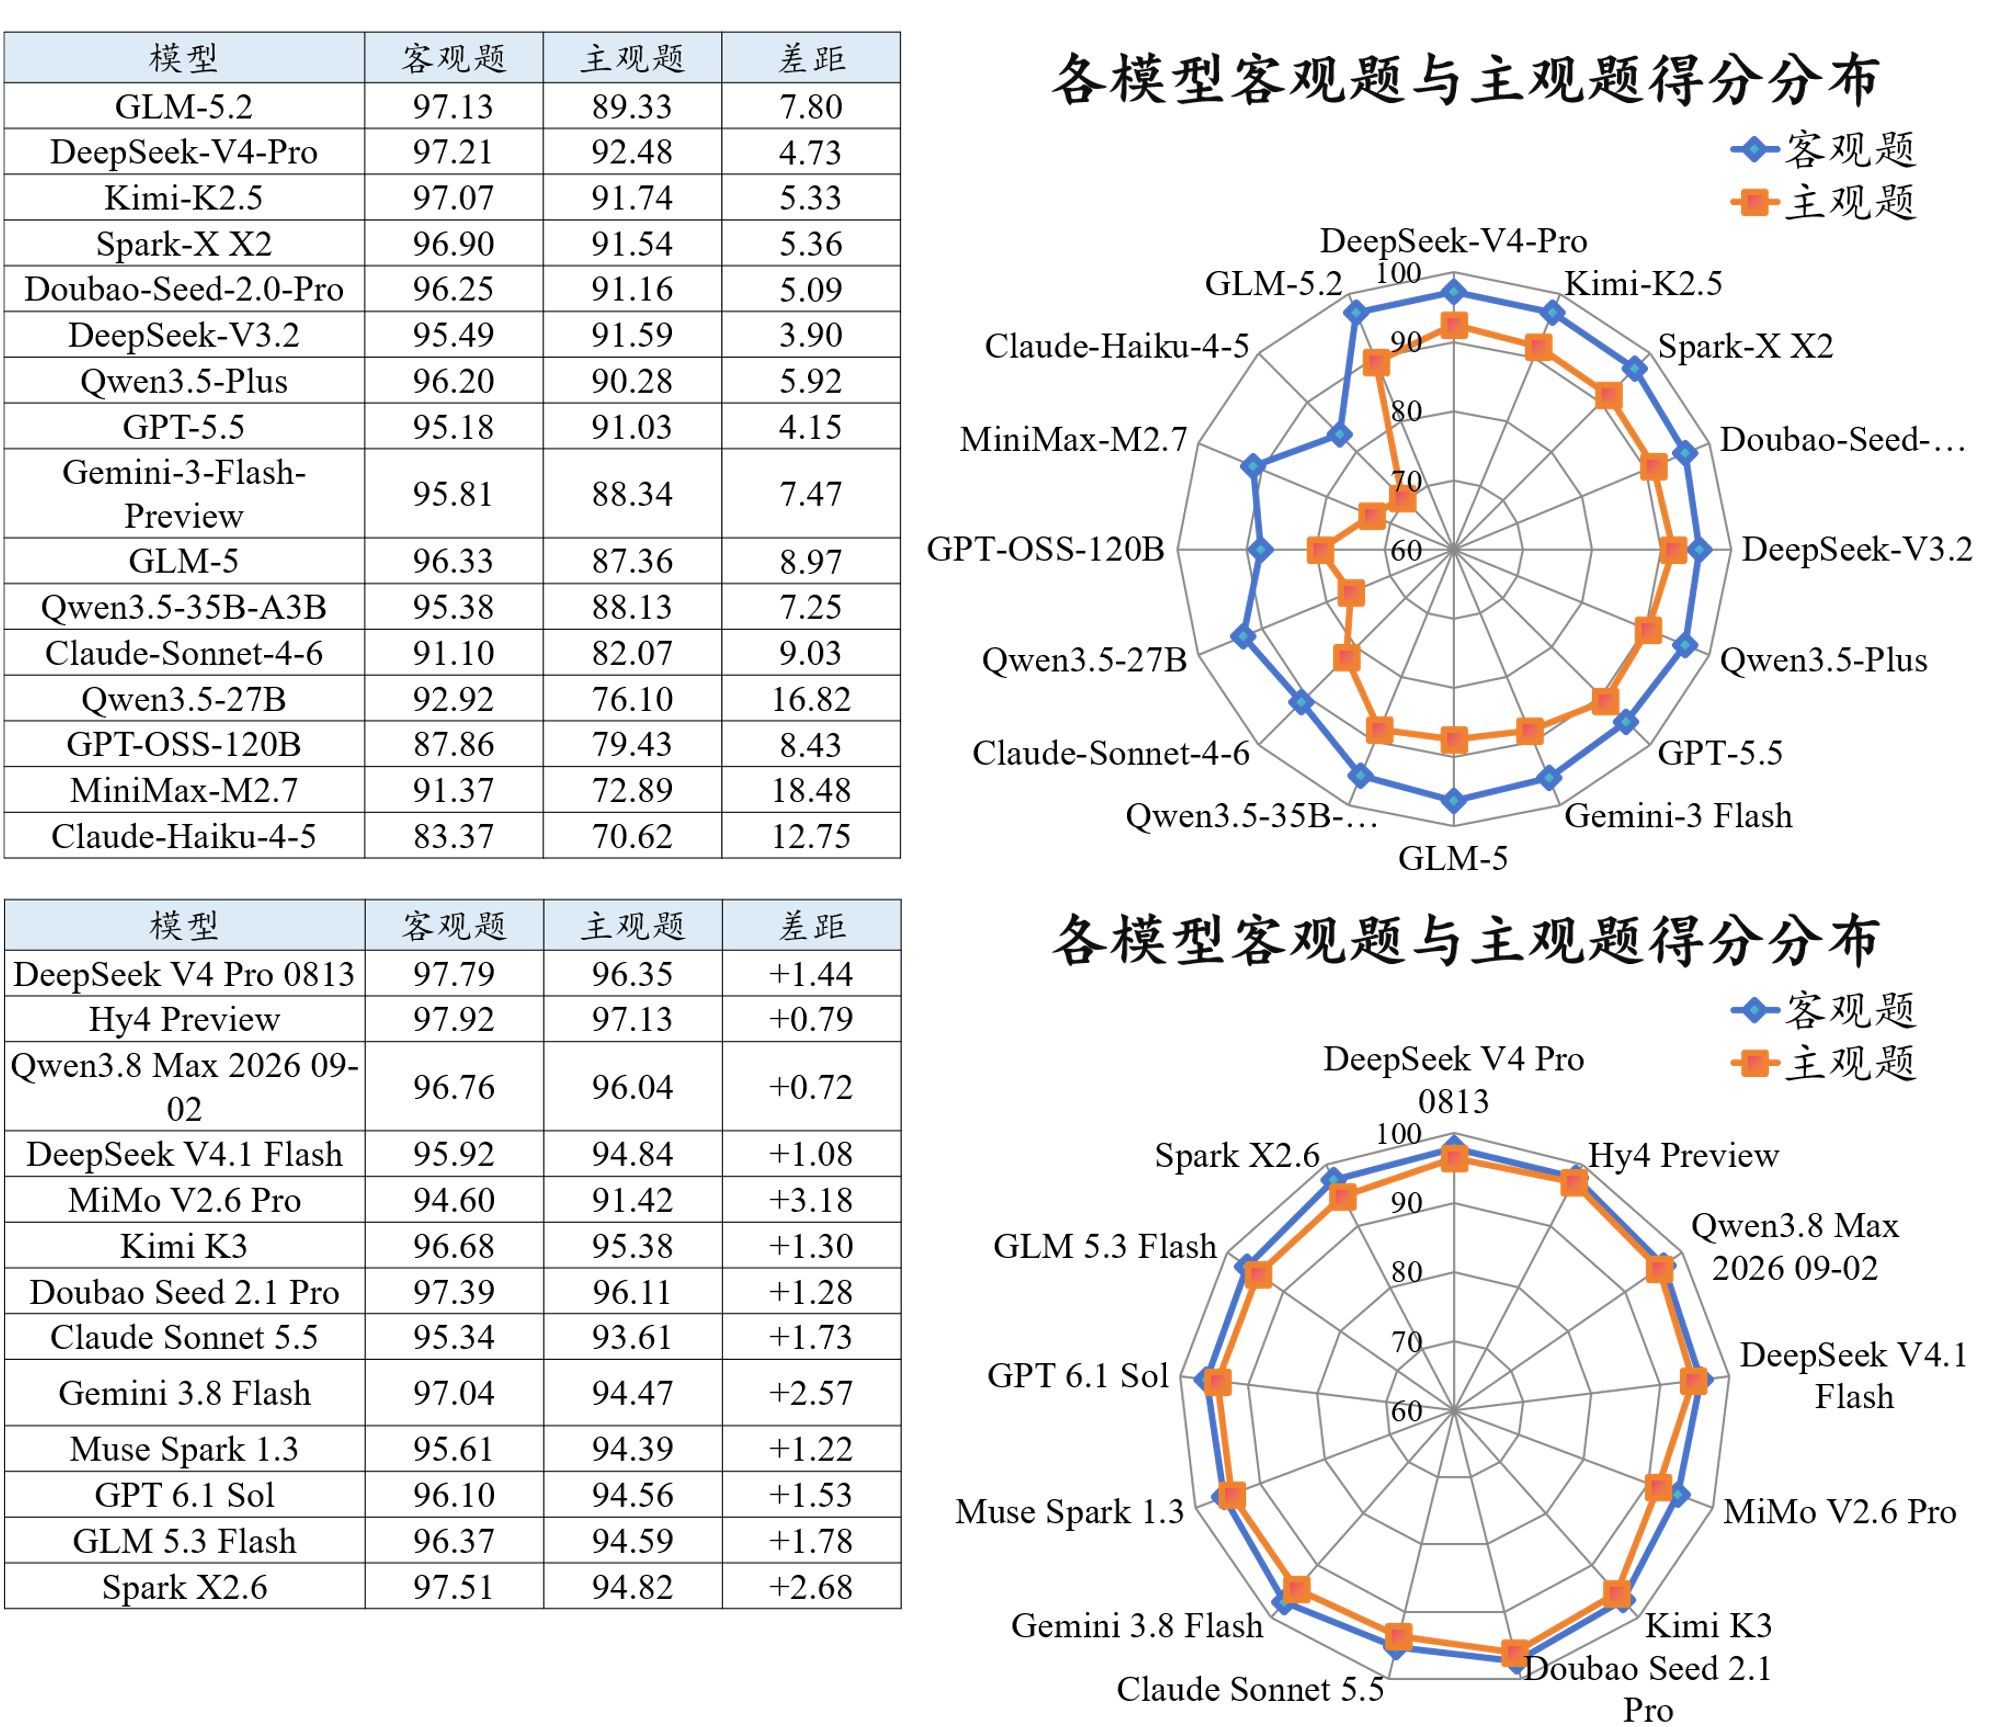
图1 学科解题主客观得分评测结果可视化(三期上,四期下)
(2)本期参评模型在记忆识别型、操作表达型和推理计算型三类认知维度的解题表现均有提升,模型间差异均较上期缩小。本期参评模型在记忆识别型、操作表达型和推理计算型的平均得分分别为96.90分、94.19分和96.00分,相比于三期的94.51分、89.85分和89.40分,分别提升2.39分、4.34分和6.60分。尽管模型的操作表达型解题表现提升明显,但仍然低于记忆识别型和推理计算型。
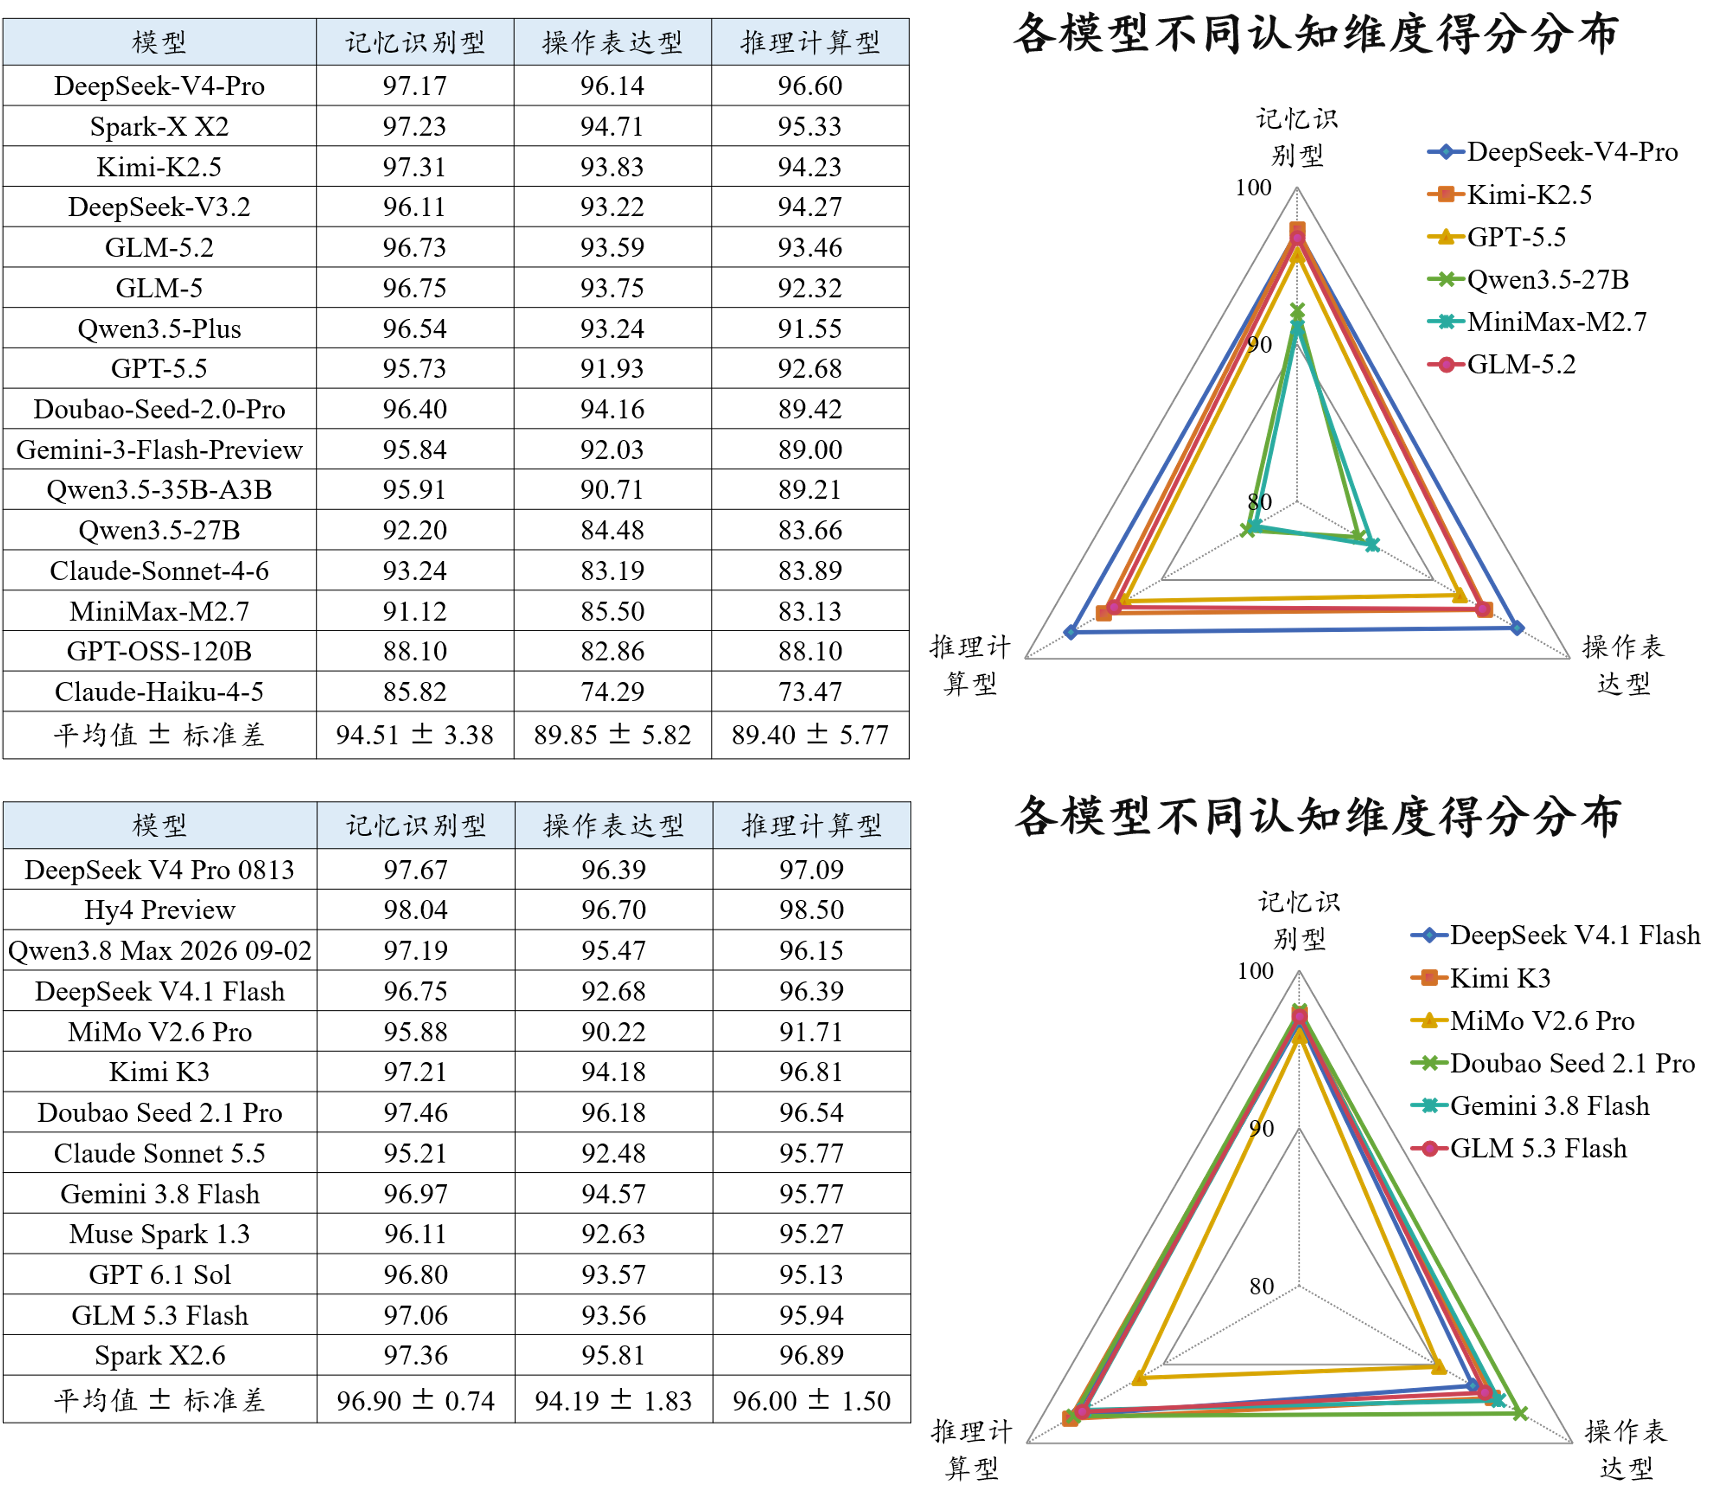
图2 学科解题不同维度评测结果可视化(三期上,四期下)
注:记忆识别型涵盖历史年代、生物分类、英语语境理解等知识类任务,操作表达型涵盖实验探究、地理实践、书面表达等需要实验操作或语言输出的任务,推理计算型涵盖图形与几何、数与代数等需要多步逻辑推导的任务。
(3)本期参评多模态模型的有图题表现明显提升,有图题与无图题的得分差距降低。本期参评多模态模型的无图题、有图题平均得分分别为96.74分和93.13分,相较于三期的94.03分和85.03分,分别提高2.71分和8.10分。本期10个参评多模态模型的有图题得分仍全部低于无图题,视觉语言跨模态推理仍值得重点关注。
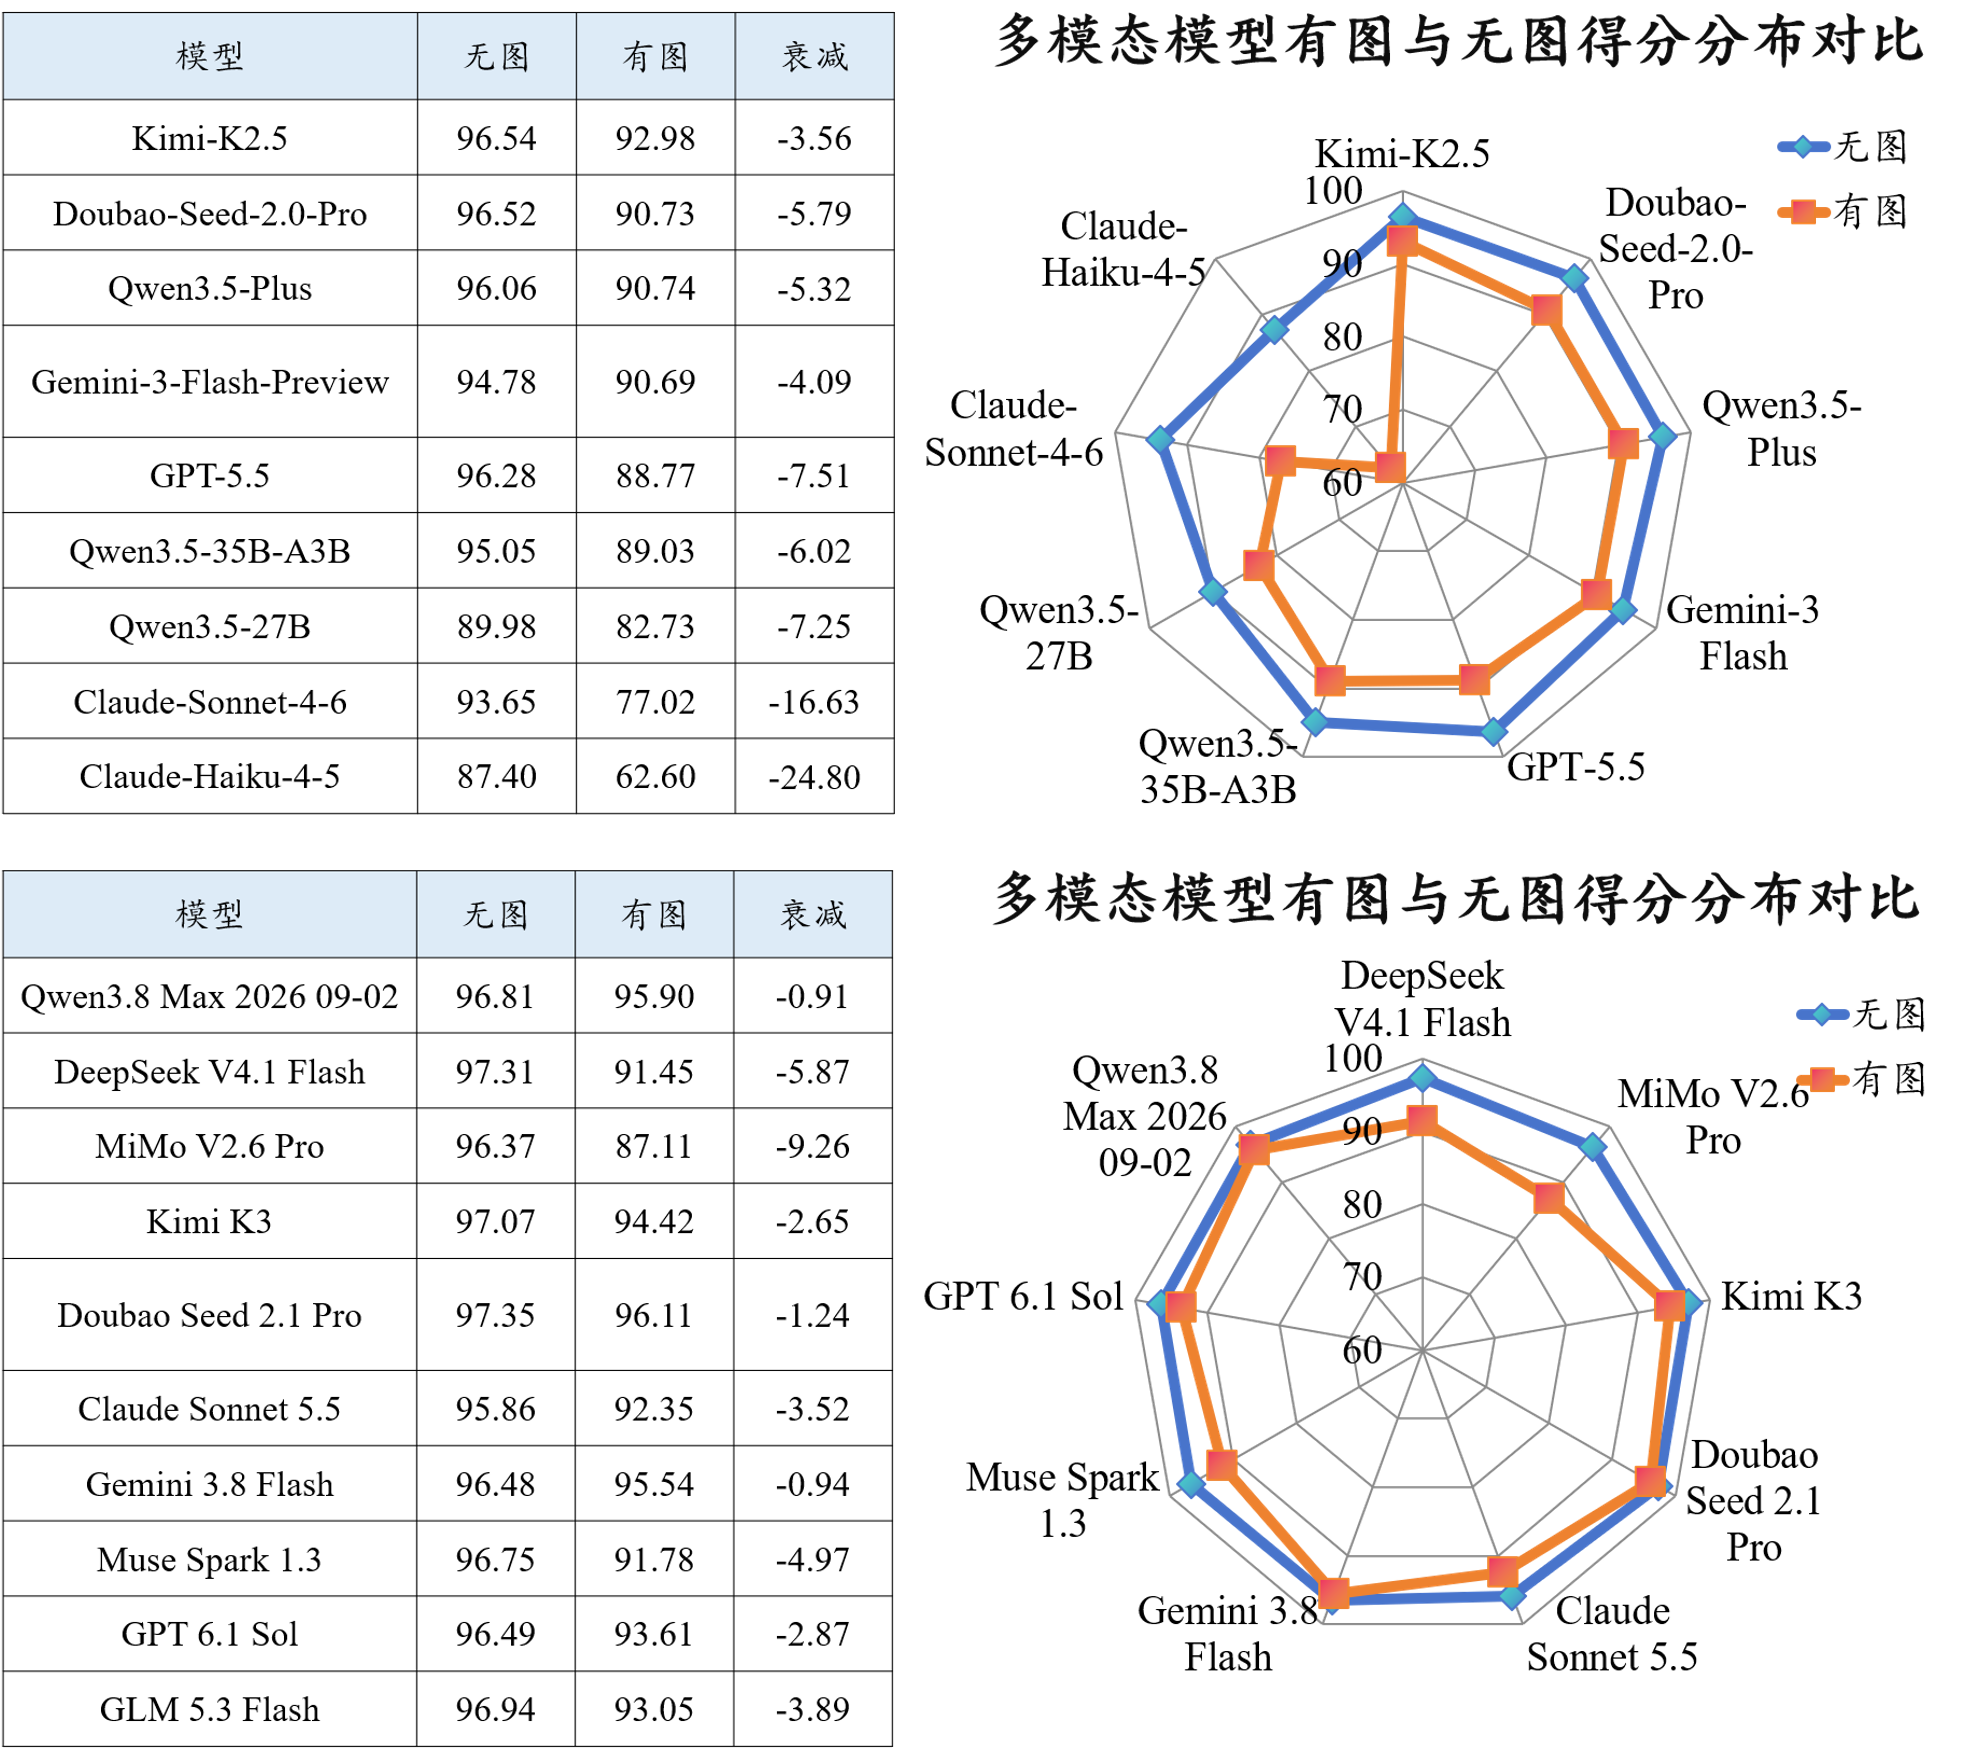
图3 有图题和无图题评测结果可视化(三期上,四期下)
二、教育应用能力评测榜单
1、智能答疑
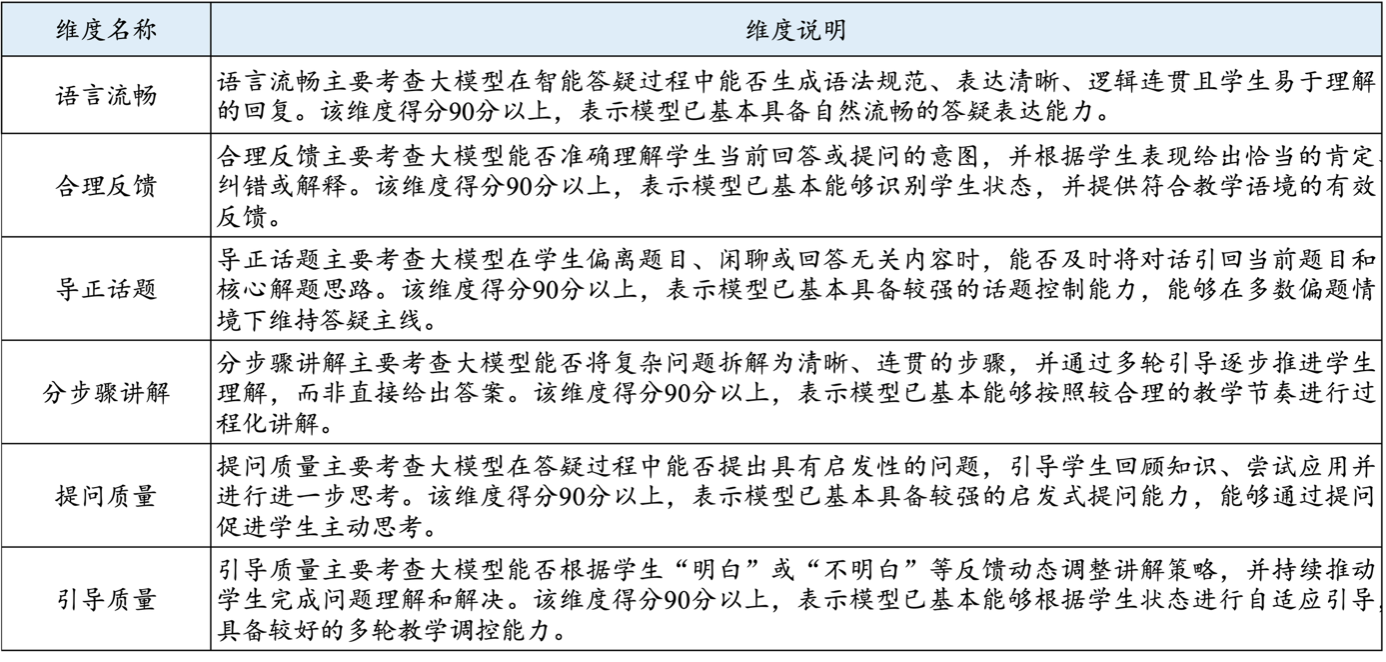
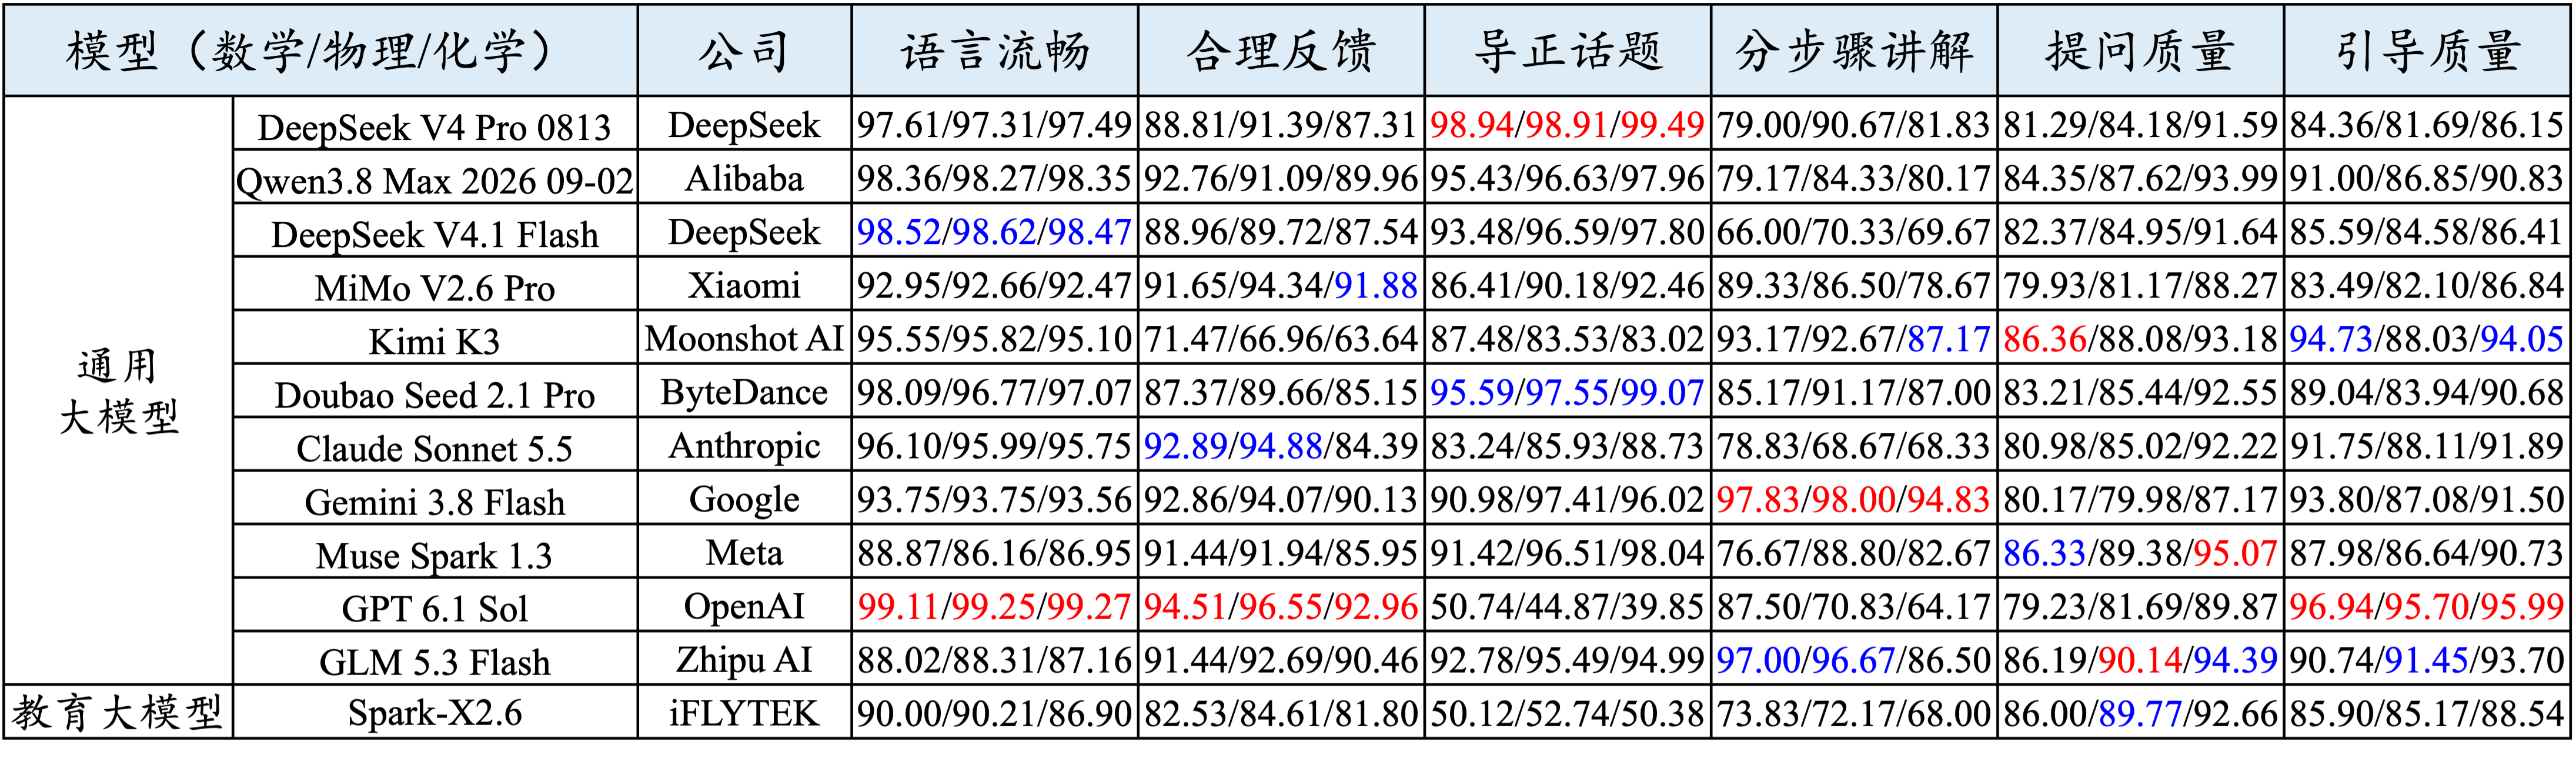
智能答疑评测聚焦大模型在基础教育教学场景中的实际应用能力,涵盖数学、物理、化学三大学科,包含语言流畅、合理反馈、导正话题、分步骤讲解、提问质量和引导质量6个核心能力评测维度。各评测维度说明如表1所示,详细评测结果见附件,从评测结果中得到以下观察。
表1智能答疑评测维度说明
(1)语言流畅保持较高水平,导正话题与分步骤讲解仍是瓶颈且模型间差异最为显著。语言流畅是参评模型均分最高的维度,均分为94.40分,导正话题和分步骤讲解是均分最低的两个维度,均分分别为85.86分和82.31分。提问质量的均分为86.85分,参评模型间标准差仅2.78分,表现相对集中。导正话题和分步骤讲解的标准差最大,分别为18.22分和9.20分。模型偏题后的回归能力与分步讲解控制仍有待提升。
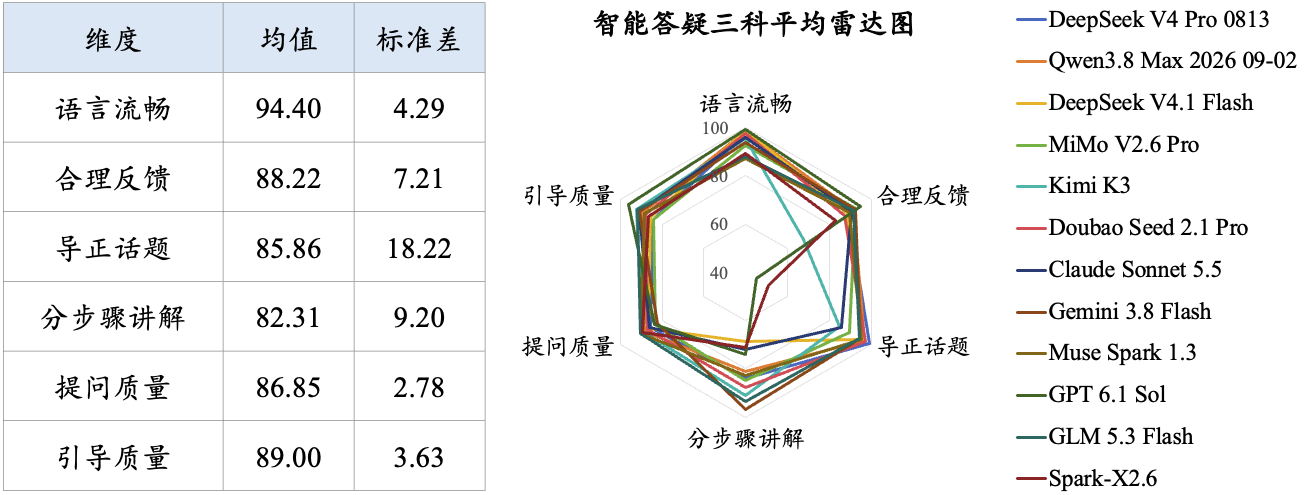
图4 智能答疑数理化评测结果可视化
(2)部分参评模型的答疑能力不均衡,优势与短板并存。GPT 6.1 Sol与Spark-X2.6的语言流畅得分分别为99.21分和89.04分,导正话题却仅45.15分和51.08分。Kimi K3的引导质量达到92.27分,合理反馈却仅67.35分,回应学生的针对性仍显不足。这表明模型的交流优势尚未充分转化为对学生学习过程的持续支持。后续应补齐话题控制与针对性反馈的短板,提升模型在答疑各个评测维度的表现均衡性。
(3)参评模型在智能答疑任务中的整体得分呈上升趋势,本期的增益主要来自合理反馈与引导质量。一至四期评测中参评模型的六维均值依次为69.35、74.88、86.72、87.77分,整体走高。相较于三期,本期参评模型在合理反馈维度的均分提高6.93分,引导质量提高8.82分。与此同时,分步骤讲解、导正话题分别下降4.32分、2.53分。后续应在巩固反馈与引导质量的同时,加强分步骤讲解和偏题后的回归能力。
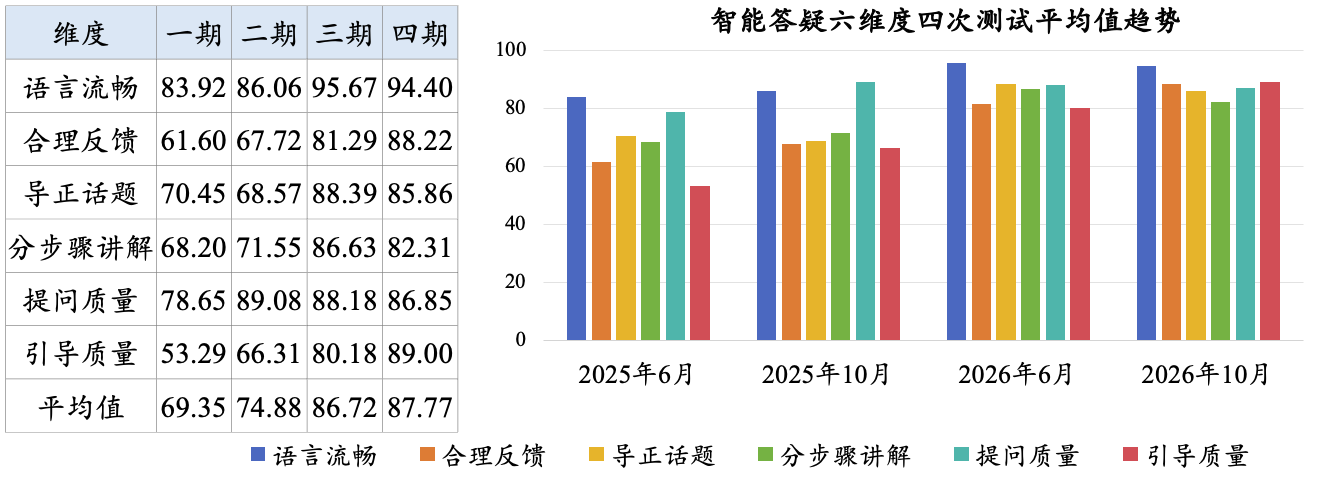
图5 智能答疑四期评测结果可视化
2、智能出题
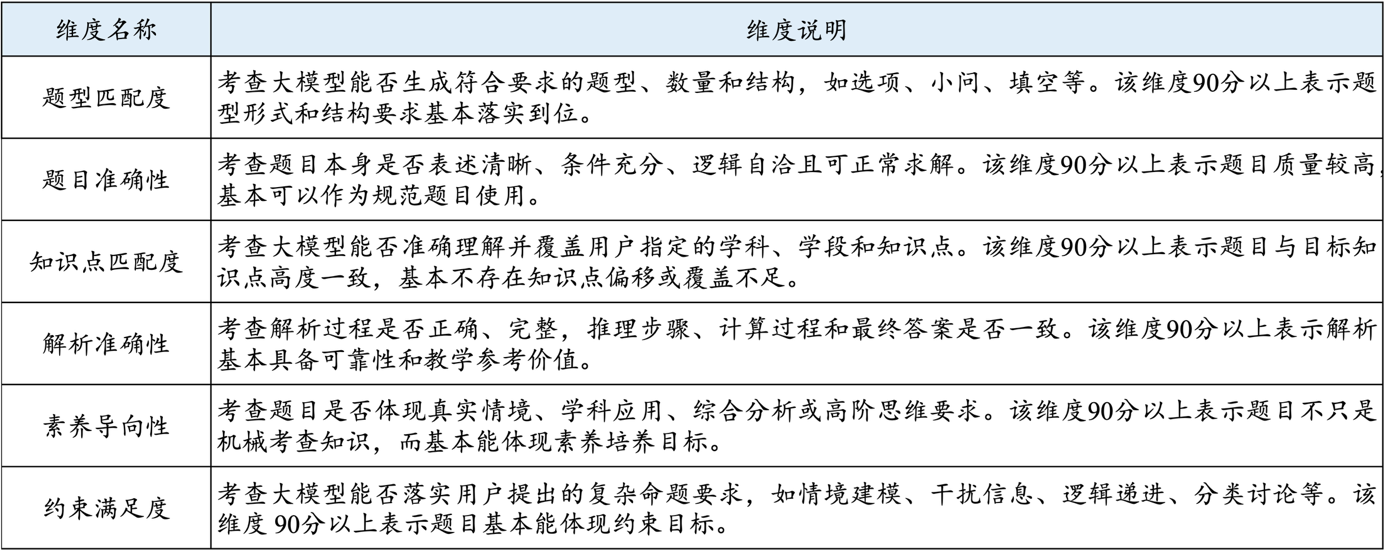
智能出题评测任务旨在从题型匹配度、题目准确性、解析准确性、知识点匹配度、素养导向性和约束满足度等维度全面评测大模型生成初中数学、物理和化学三门学科题目的能力。各评测维度说明如表2所示,详细评测结果见附件,从评测结果中得到以下观察。
表2智能出题评测维度说明
(1)相较于三期评测,本期参评模型的题型匹配度和知识点匹配度基本持平,约束满足度、素养导向性、题目准确性和解析准确性提升明显。参评模型在题型匹配度和知识点匹配度的三科均分分别是89.03分和87.85分。约束满足度、素养导向性、题目准确性和解析准确性的三科均分分别是87.82分、56.57分、95.09分和96.70分,相较于三期分别提高17.67分、11.07分、5.13分和8.84分。尽管参评模型的素养导向性提升较大,该维度均分仍明显低于其余5个维度。
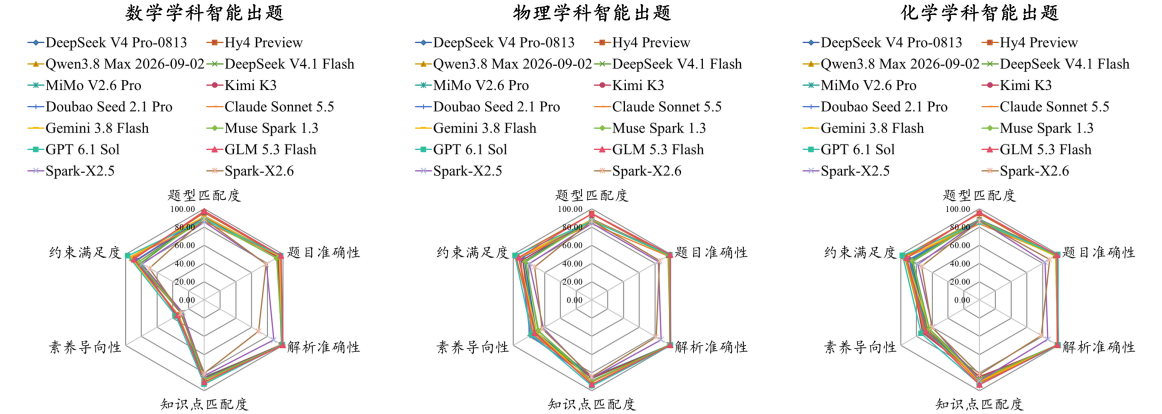
图6 智能出题分学科评测结果可视化
(2)与三期评测一致,命题需求下参评模型在素养导向维度提升明显,题型匹配度、解析准确性、题目准确性和知识点匹配度出现下降。命题需求下的总体均分为85.51分,较基础需求的83.22提高2.29分。从质量维度变化看,命题需求下的素养导向性较基础需求提高19.78分,题型匹配度、题目准确性、解析准确性和知识点匹配度分别下降0.71分、2.12分、1.65分和3.68分。
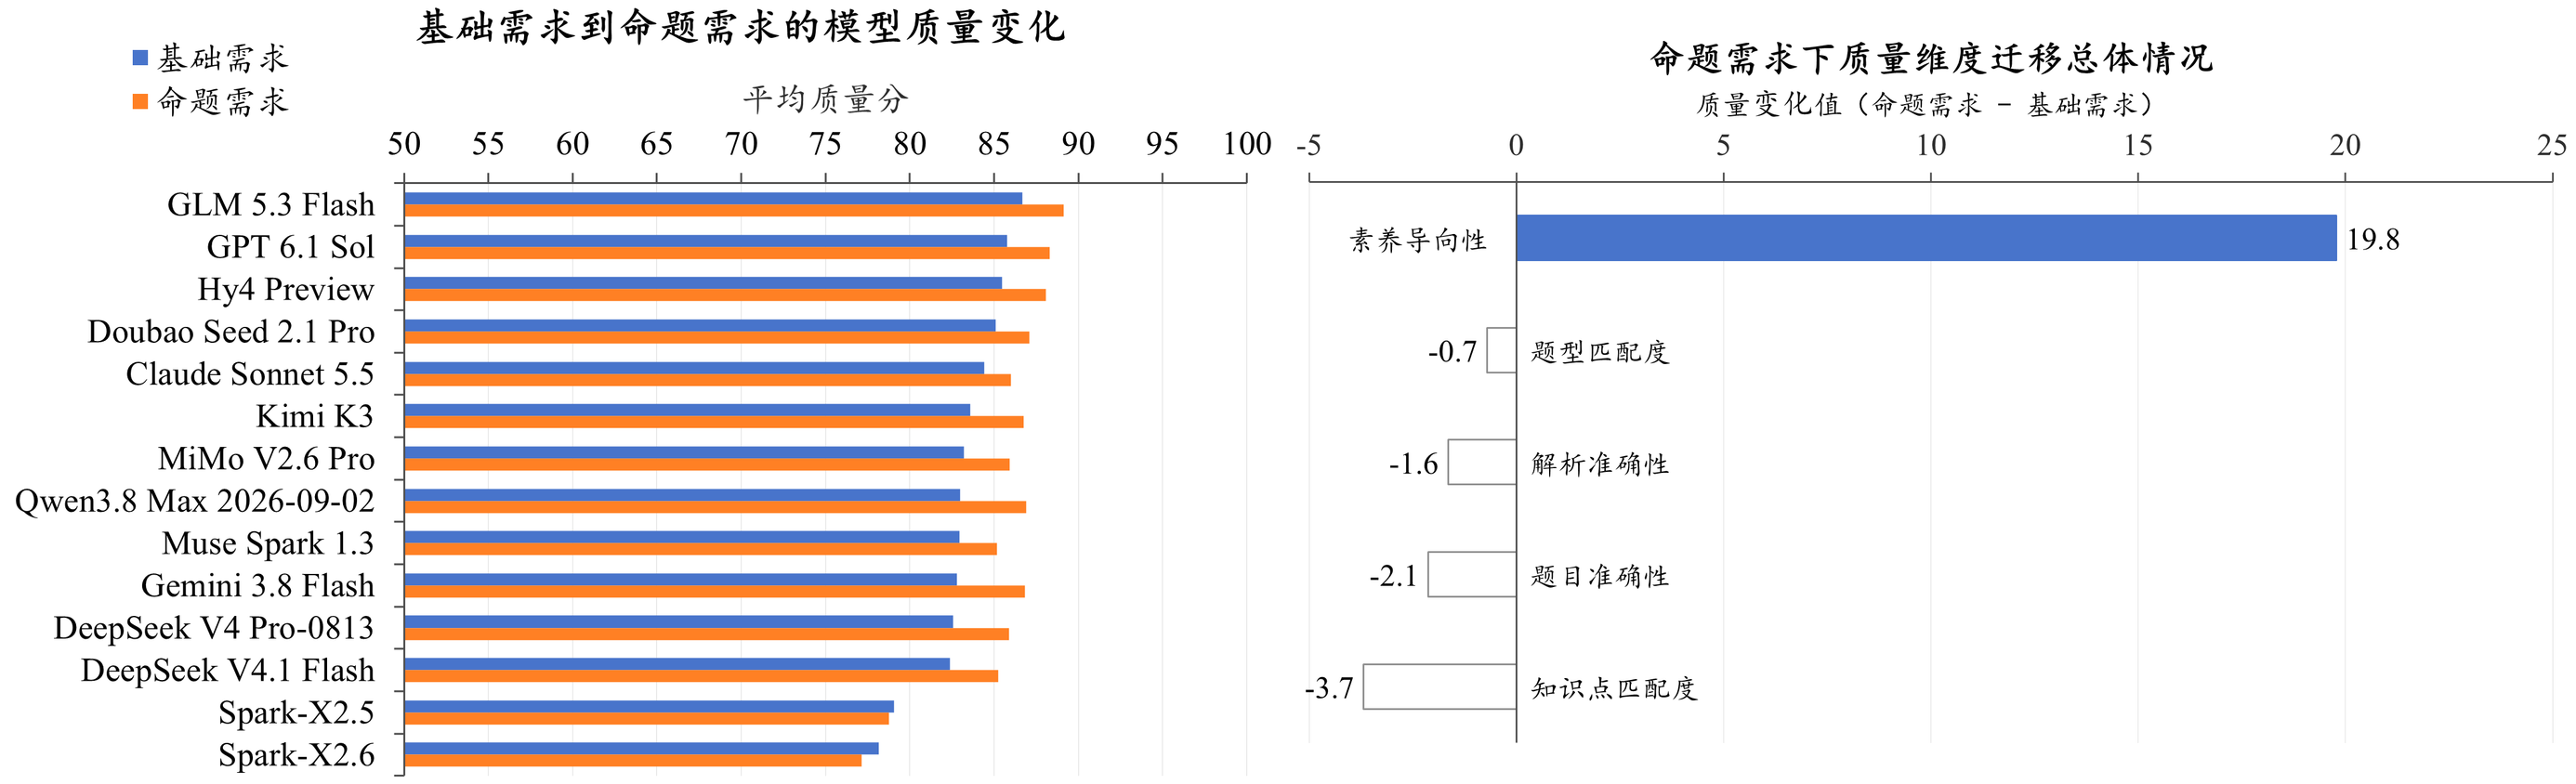
图7 智能出题命题需求对模型及维度的影响
(3)与三期评测一致,参评模型在九类命题需求上表现出明显的能力分化。参评模型在新定义、干扰数据、真实情景建模和条件碎片化呈现命题需求下的均分超过94分,在隐性约束、临界与切换点、预期目标需求下的均分分别为88.0分、85.8分和84.9分,在逻辑链式与错误路线需求下的均分分别为77.7分和75.4分。相较于三期,本期模型在九类需求下表现均有提升,且各需求下的参评模型间得分差距进一步缩小。
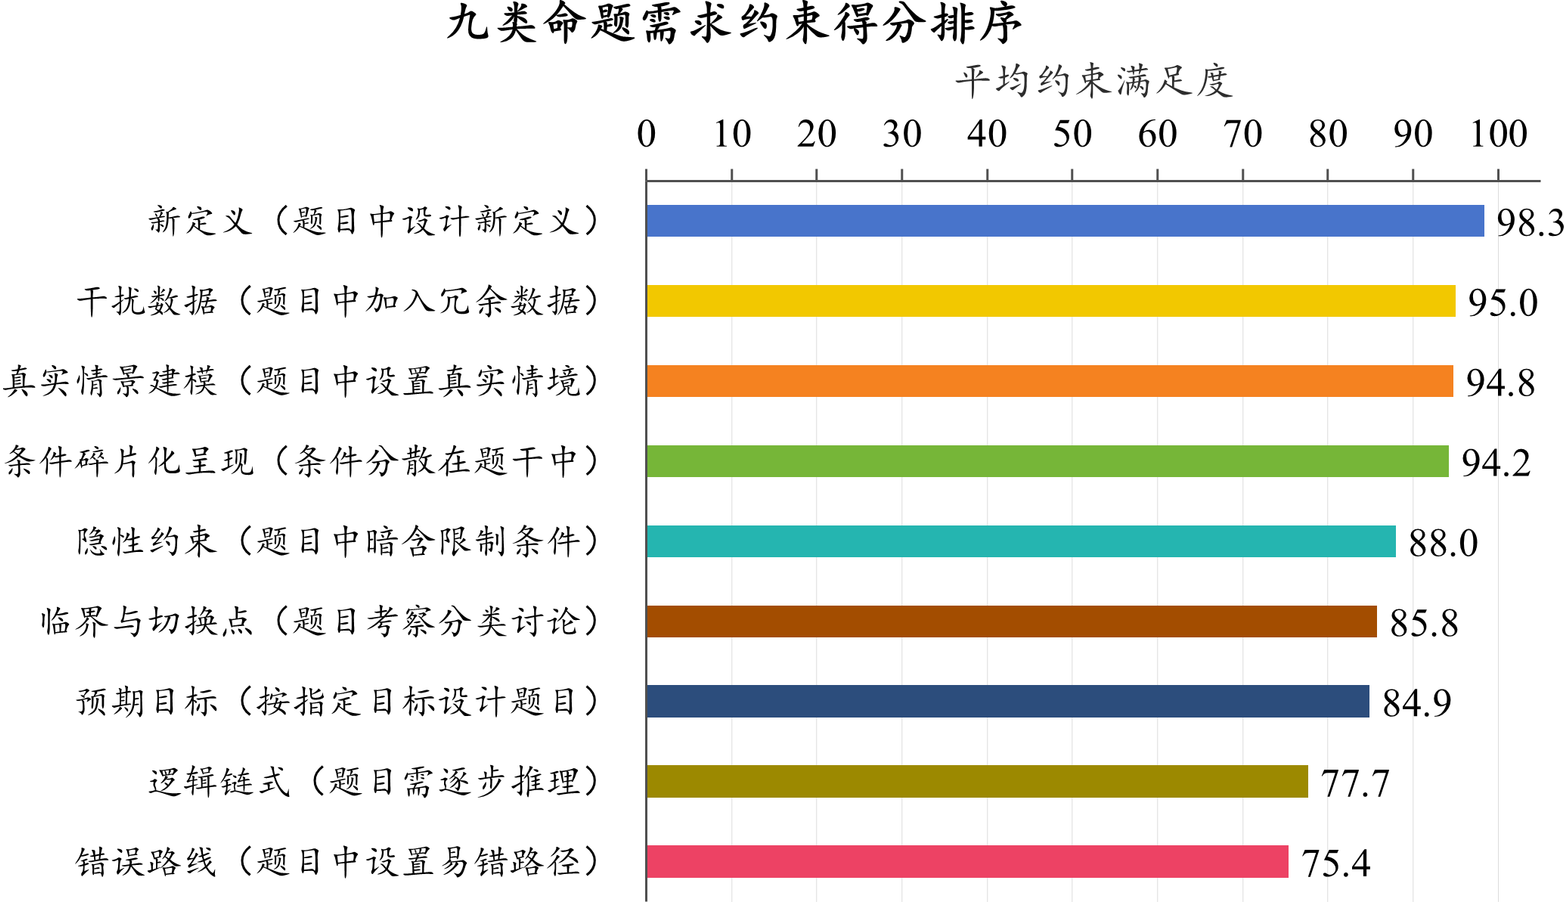
图8 本次智能出题九类命题需求约束满足度
3、教案生成
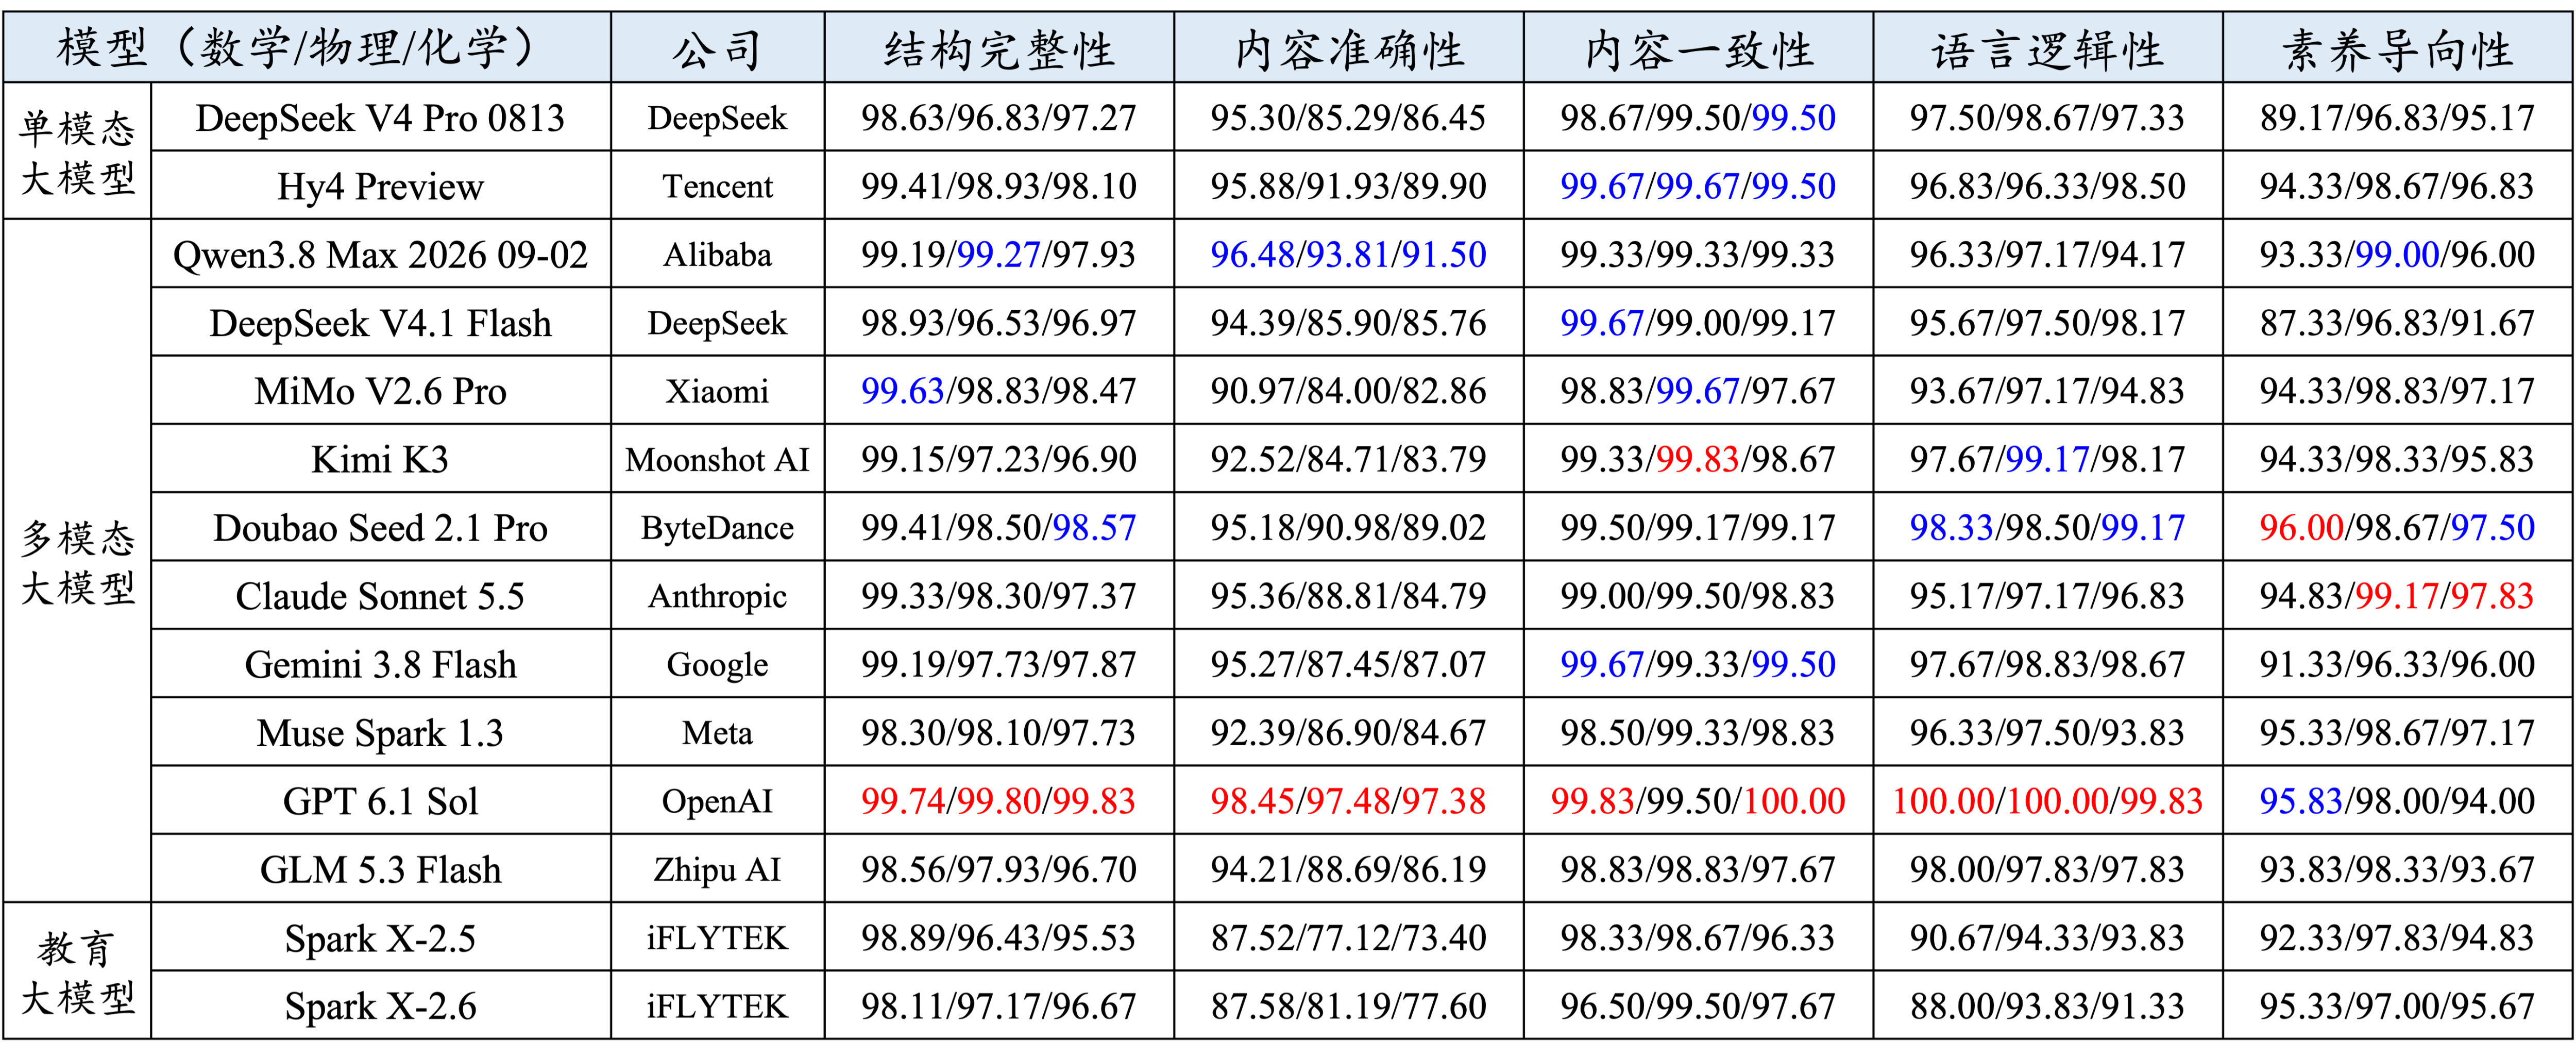
教案生成评测任务旨在从结构完整性、内容准确性、内容一致性、语言逻辑性和素养导向性等维度全面评测大模型生成初中数学、物理和化学三门学科教案的能力。各评测维度说明如表3所示,详细评测结果见附件,从评测结果中得到以下观察。
表3 教案生成评测维度说明
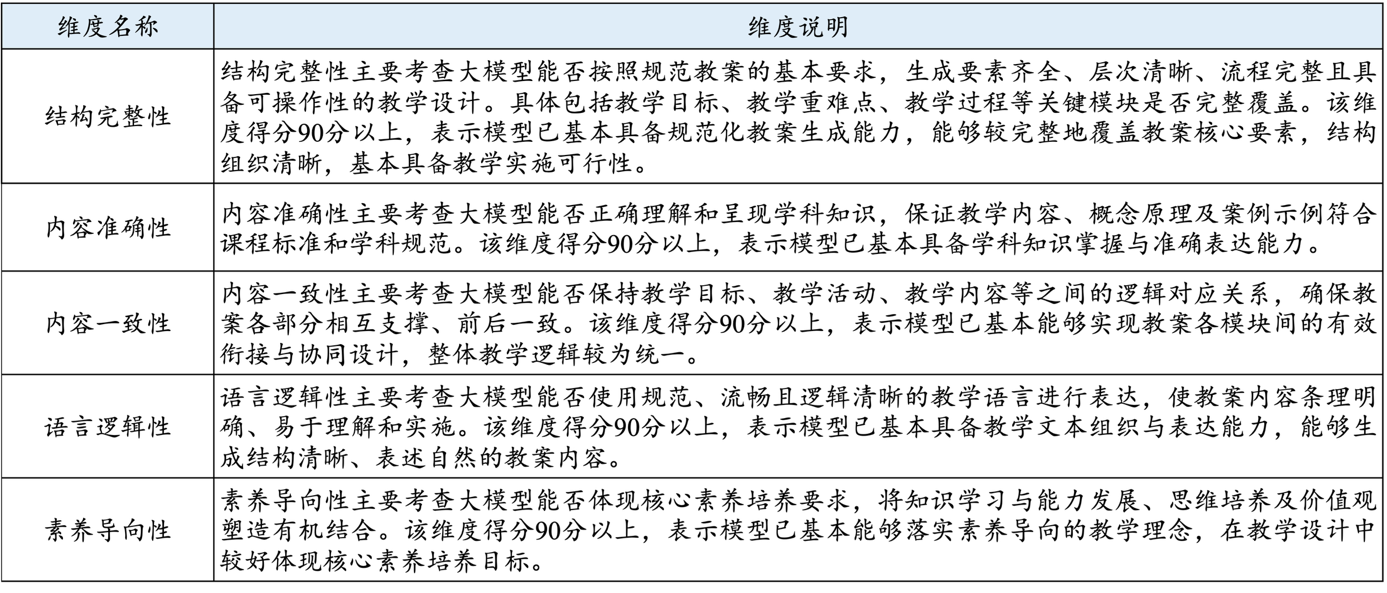
(1)内容准确性仍是教案生成的主要短板,模型间差异最为显著。本期参评模型在数学、物理和化学三科的结构完整性和内容一致性的均分均超过97分,表明参评模型具备较强的教案框架组织和教学文本表达能力。数学、物理和化学三科的内容准确性均分分别为93.68分、87.45分和85.74分,延续了前三期评测中内容准确性相对薄弱的特点,仍需重点加强生成教案的学科知识的可靠性及教学内容的充分性。
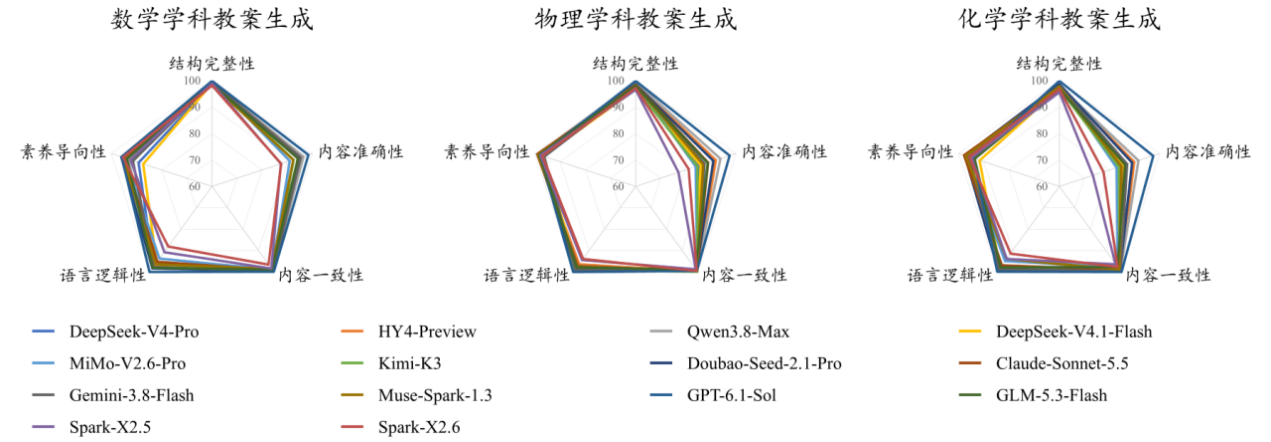
图9 教案生成分学科评测结果可视化
(2)结构完整性与内容准确性持续改善,其他维度保持较高水平。相较于第三期,本期参评模型在数学、物理和化学三科的结构完整性、内容准确性、素养导向性均有所提高。三科的内容准确性均分分别提高4.15、5.17和5.98分。数学的素养导向性由88.12分提高至93.40分,提高5.28分。内容一致性和语言逻辑性保持较高水平,内容一致性的均分均超过98分,语言逻辑性的均分均超过95分。
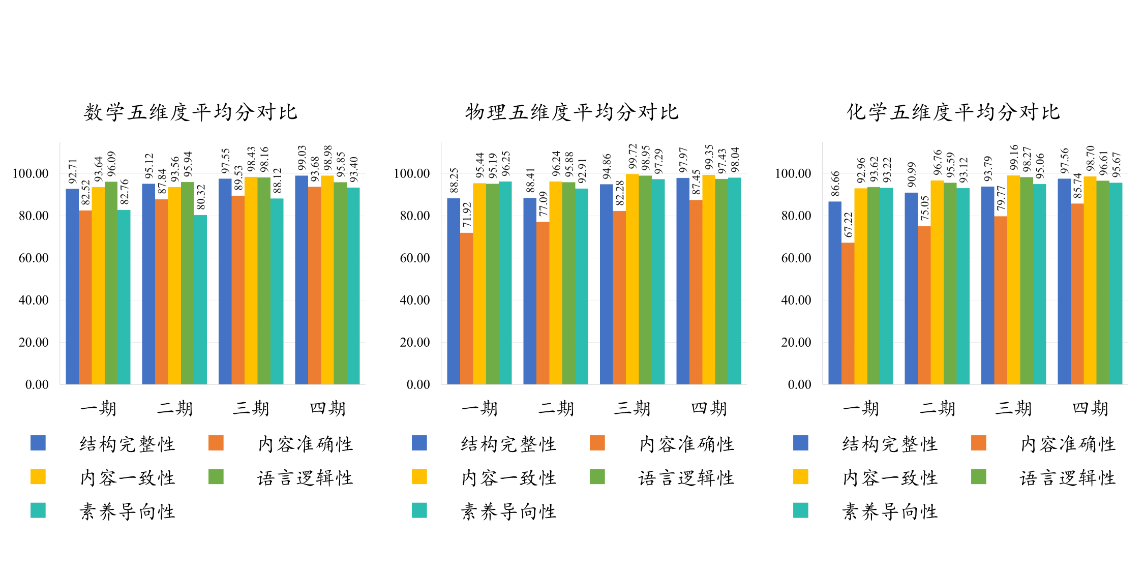
图10 教案生成四期五维度平均分对比
(3)少数模型具有均衡的学科适应能力,部分模型具备单科优势但学科间表现尚不均衡。本期参评模型中,GPT 6.1 Sol的三科的总分均居本期首位,且三科最高与最低总分仅相差0.61分,表现出较好的学科均衡性。与此同时,部分模型仍存在较明显的学科差距,例如Claude Sonnet 5.5的数学总分为96.96分,化学为91.59分,相差5.37分。如何针对学科特点提升模型的教案生成质量,仍是未来优化的重要方向。
4、口语练习
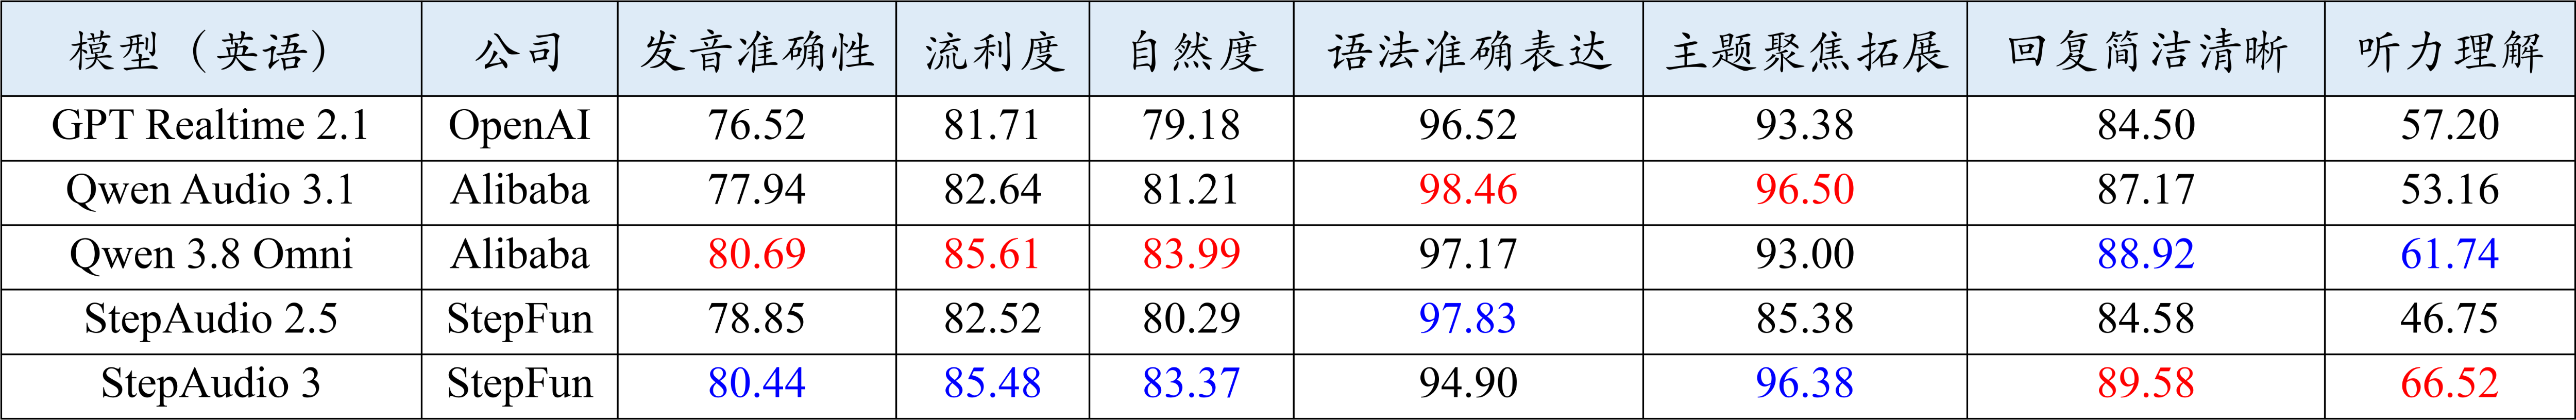
口语练习评测任务旨在评估大模型在英语学科口语练习中的表现。任务输入包括学生真实语音及模型的单轮回复,评测输出为待测模型在发音准确性、流利度、自然度、语法准确表达、主题聚焦拓展、回复简洁清晰和听力理解7个评测维度上的分数。各评测维度说明如表4所示,详细评测结果见附件,从评测结果中得到以下观察。
表4 口语练习评测维度说明
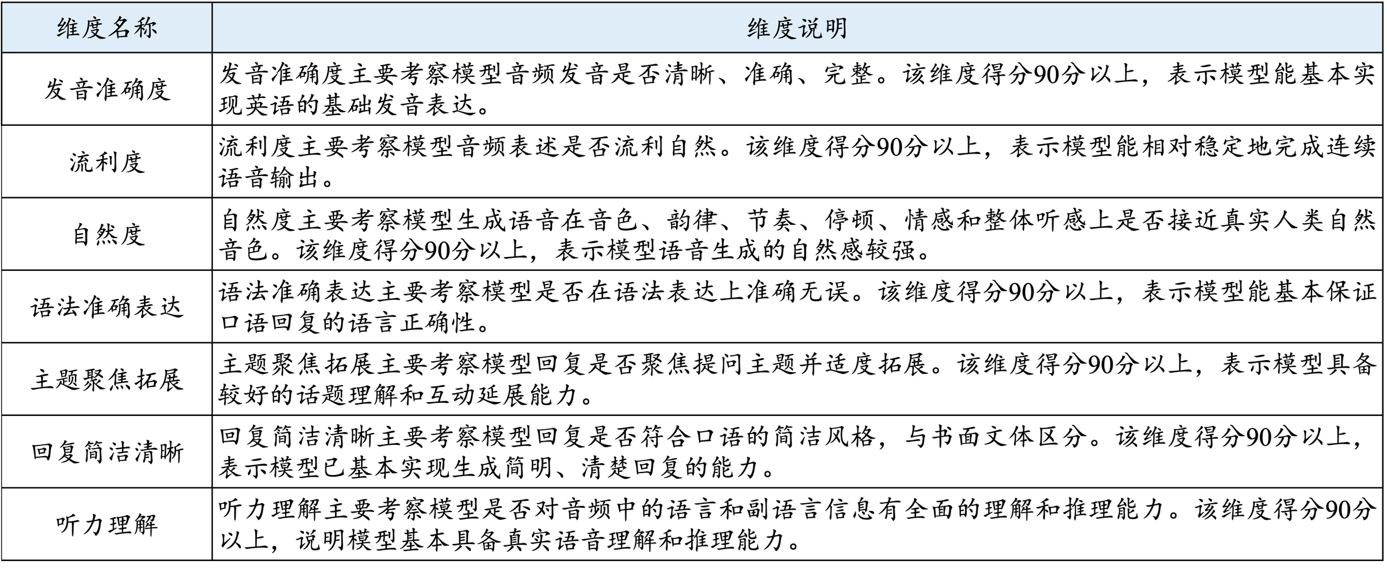
表5 口语练习的听力理解的五类能力说明
(1)基础表达保持较高水平,交互质量仍需提升。本期参评模型的语法准确表达和主题聚焦拓展均分为96.98分和92.93分,相较于三期的95.82分和91.55分,分别提升1.16分和1.38分;简洁清晰维度得分为86.95分,与三期基本持平。总体来看,参评模型的基础语言组织能力较为稳定,但简明、清楚回复的能力仍有优化空间。
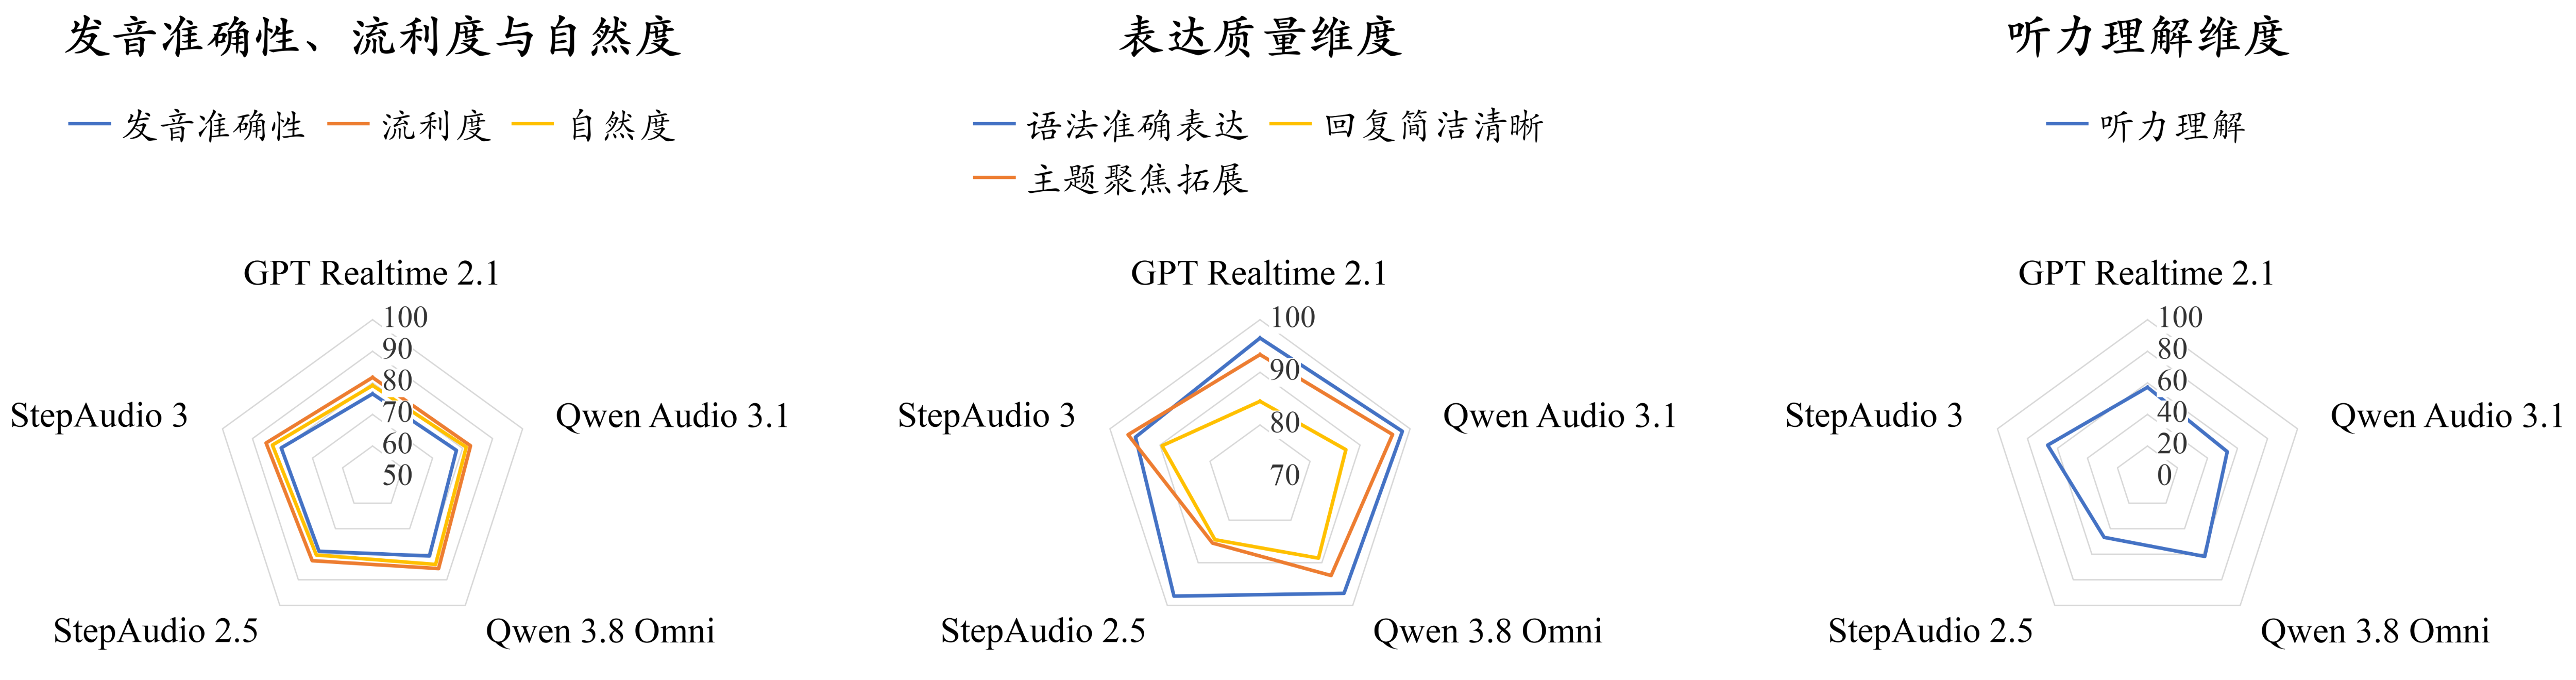
图11 英语学科口语练习部分评测结果可视化
(2)国产模型延续场景化优势,语音输出表现较好。本期参评的4款国产模型的发音、流利度、自然度和简洁清晰均高于本期的GPT Realtime 2.1。Qwen 3.8 Omni的发音与流利度为80.69分、85.61分,StepAudio 3的简洁清晰维度得分为89.58分。但主题回应与听力仍有国产模型低于GPT,因此模型的输出优势还需与切题回应和听力理解结合,才能更好地支持学生交流。
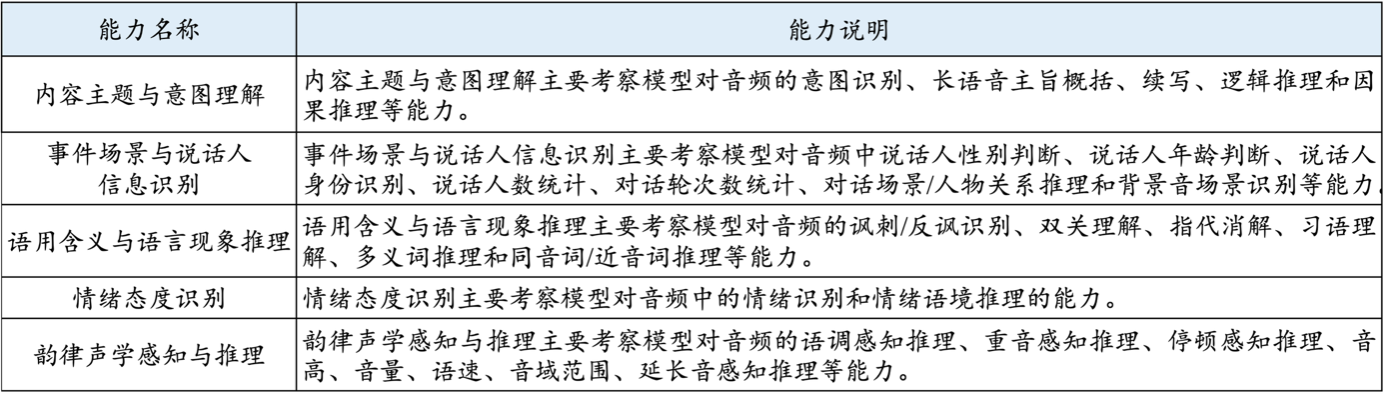
(3)听力均分高于三期,听力深层理解仍是短板。本期参评模型听力理解均分为57.07分,相较于三期的50.21分提升6.86分;但本期听力理解最高分为StepAudio 3的66.52分,仍未超过三期Qwen3.5-Omni-Plus的72.15分。韵律声学感知与推理、事件场景与说话人信息识别、情绪态度识别维度均表现不足,最高分分别为57.93分、64.49分和52.40分。应继续加强音频深层理解能力,以提高对学生表达意图的把握。
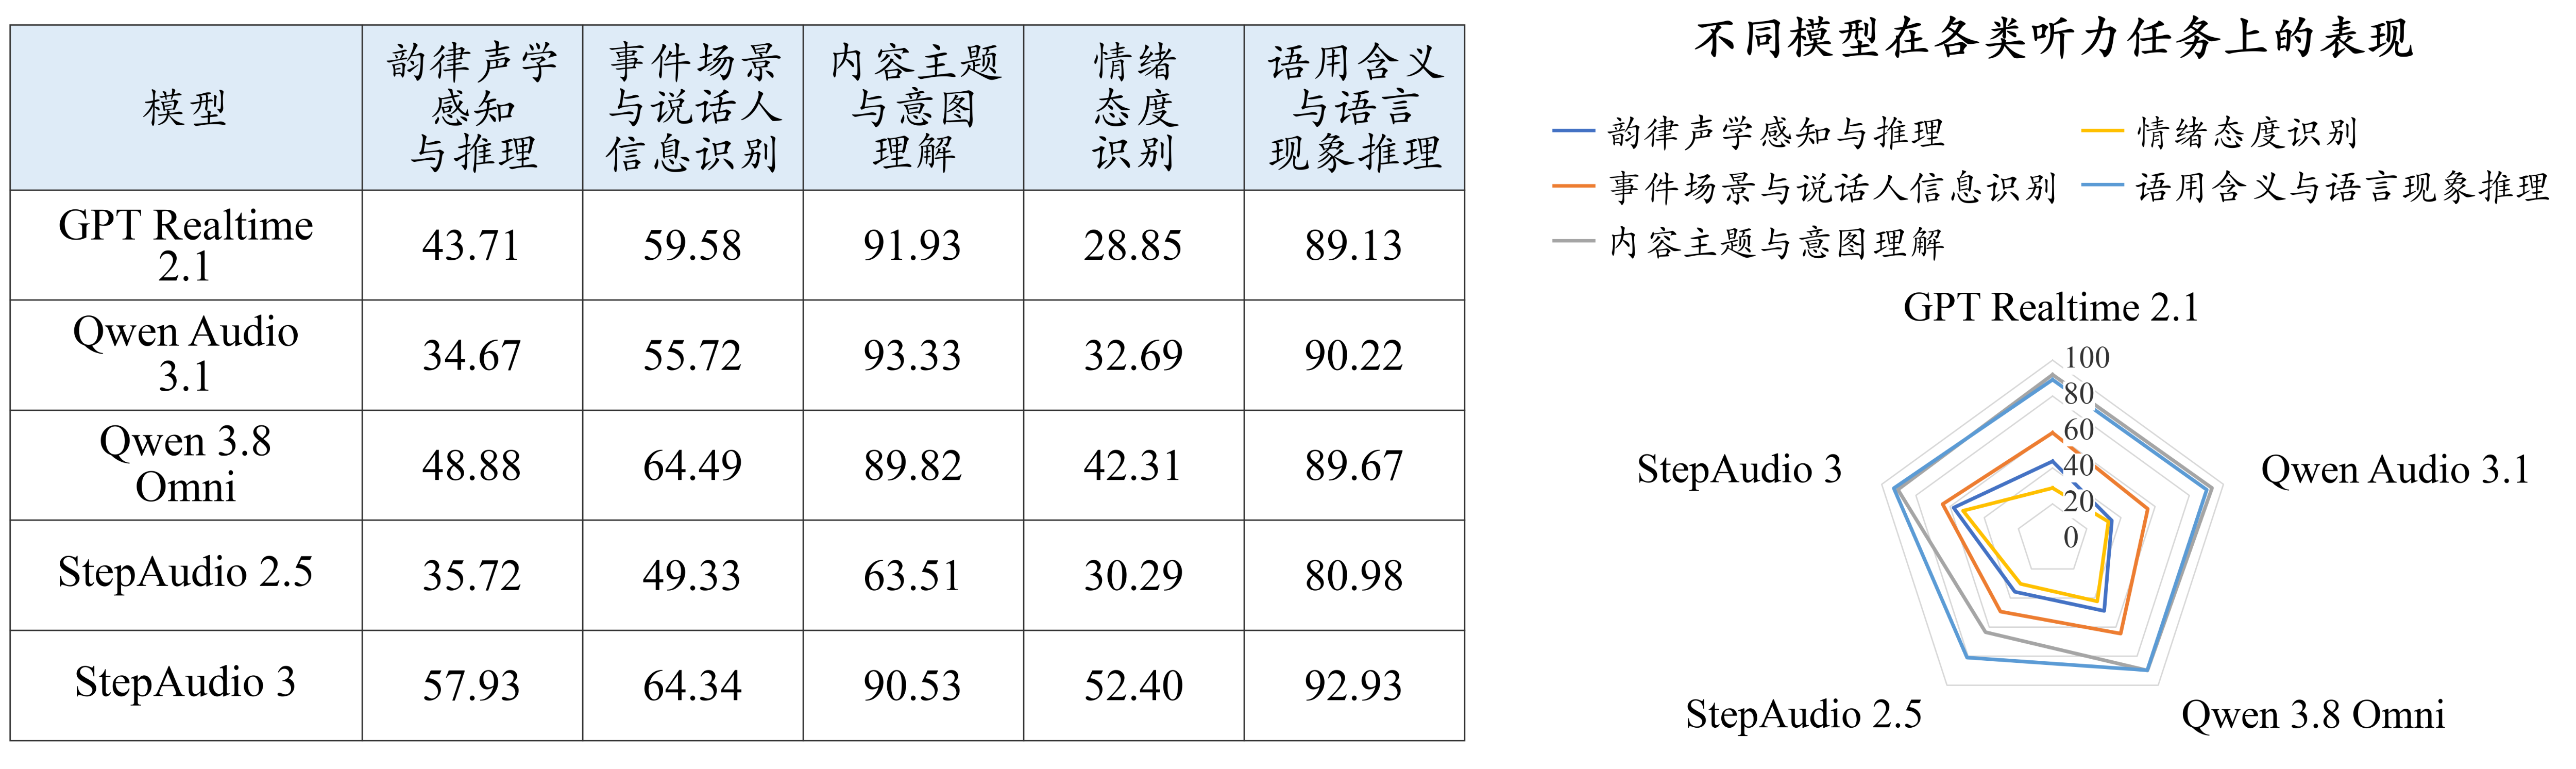
图12 英语学科口语练习的听力理解评测结果可视化
5、作文批改
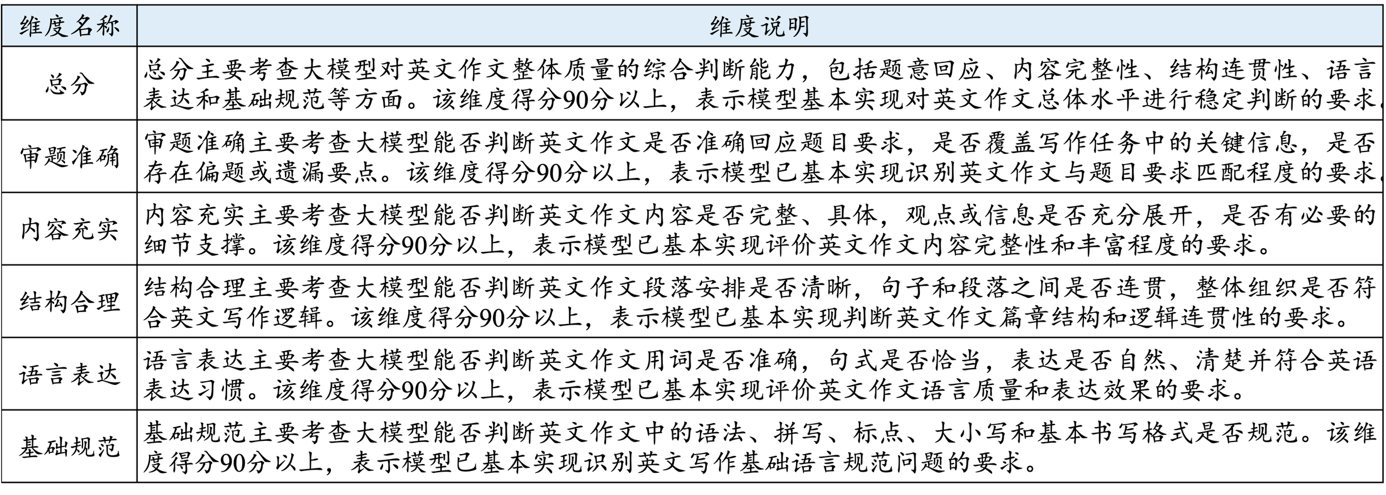
作文批改评测聚焦大模型在语文作文与英语作文场景下的综合批改能力。评测任务以作文题干与学生作文内容为输入,学生作文内容存在图片和文本两类形式,依据中英文作文评价标准构建总分、通用维度、文体专项维度及细粒度纠错指标。其中,语文作文评价维度包括审题准确、内容充实、结构合理、语言表达、书写规范,并进一步区分记叙文和议论文专项维度;英文作文评价维度包括审题准确、内容充实、结构合理、语言表达和基础规范。语文作文批改的部分评测维度说明如表6所示,英语作文批改的部分评测维度说明如表7所示。除整体评分外,评测还考察模型的细粒度纠错能力,即对标点、错别字/拼写、语法、缺词、多字等细粒度问题的发现与修改能力。详细评测结果见附件,从评测结果中得到以下观察。
表6语文作文批改的部分评测维度说明
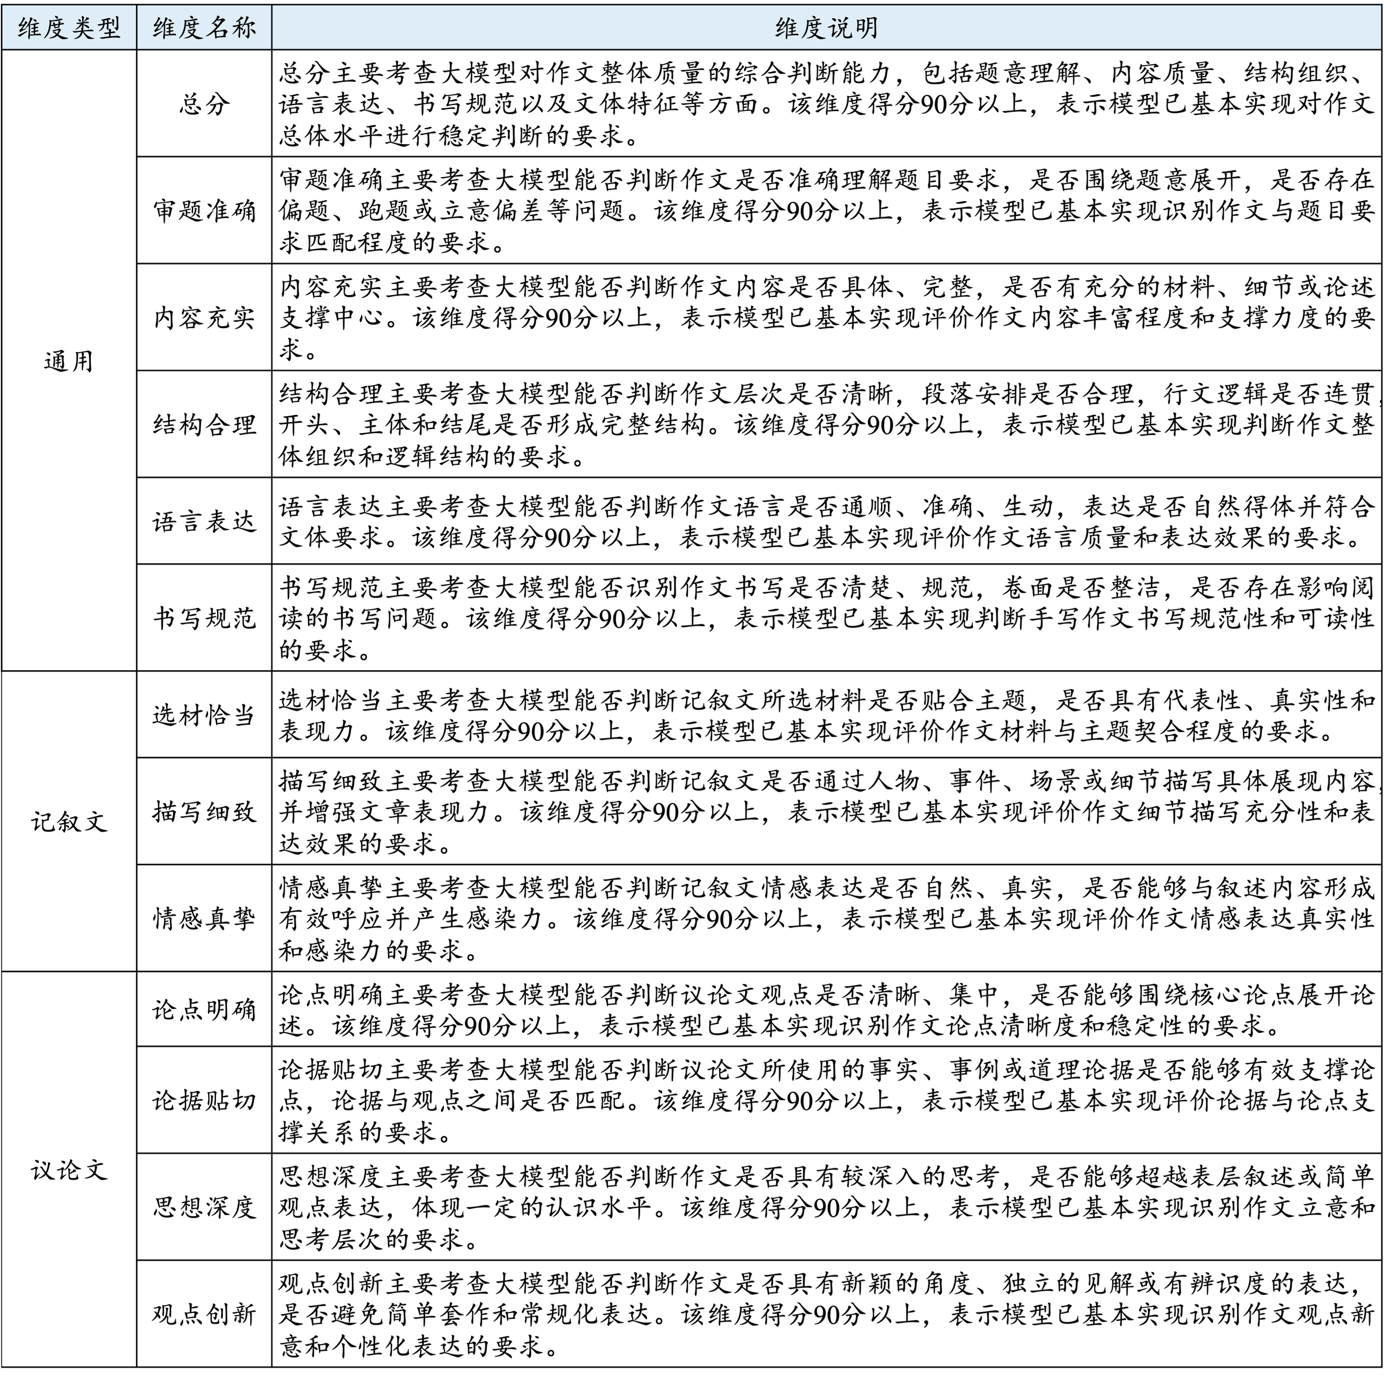
表7 英语作文批改的部分评测维度说明
(1)本期参评模型在低分段作文上的评分表现有所提升,不同分数段的得分差距缩小,但仍存在“低分高估、高分低估”的问题。本期语文、英语低分段作文的总分评分较上期分别提升6.45分和4.29分;与中分段的得分差距分别由上期的10.45分、9.45分缩小至3.85分、4.07分。这表明本期参评模型在低分作文上的评分表现有所改善,但对不同质量作文的评分仍存在偏差,评分尺度仍有待进一步校准。
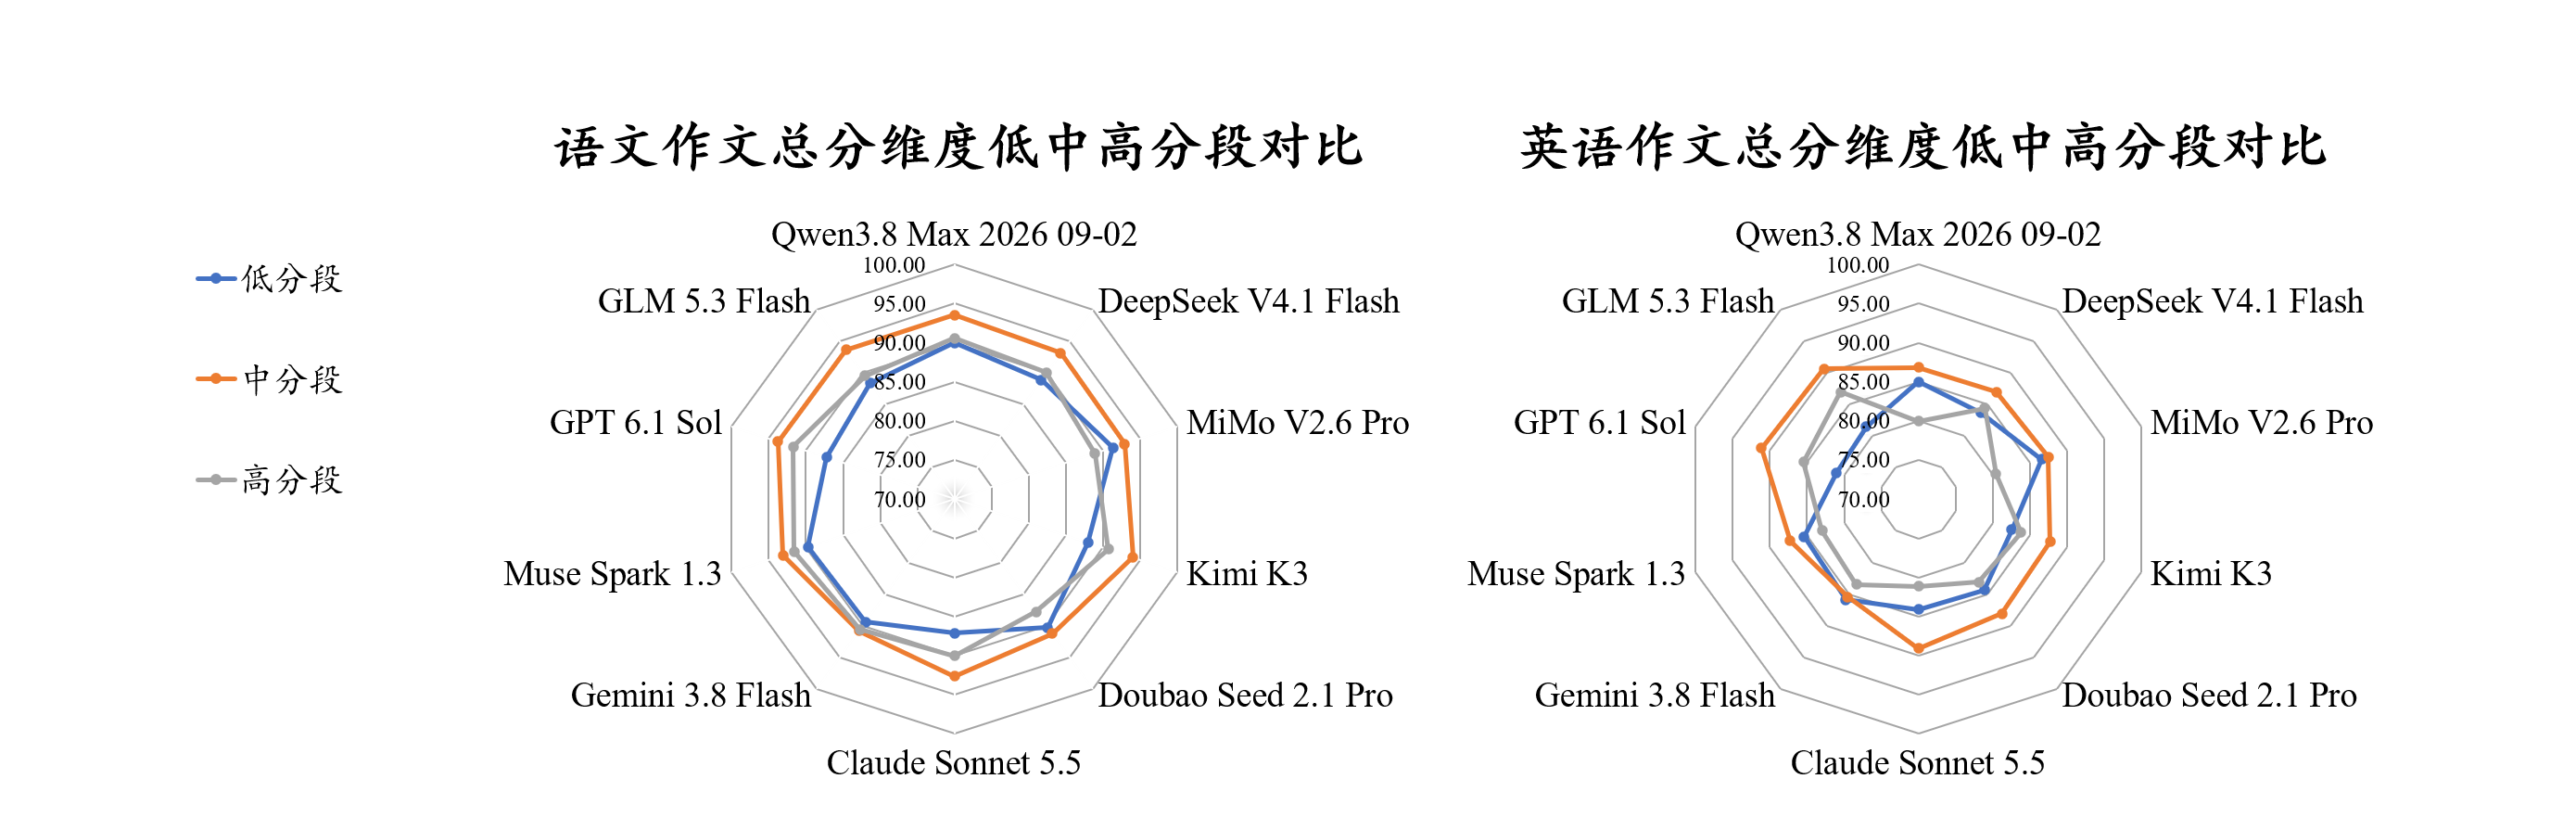
图13 作文批改部分评测结果可视化
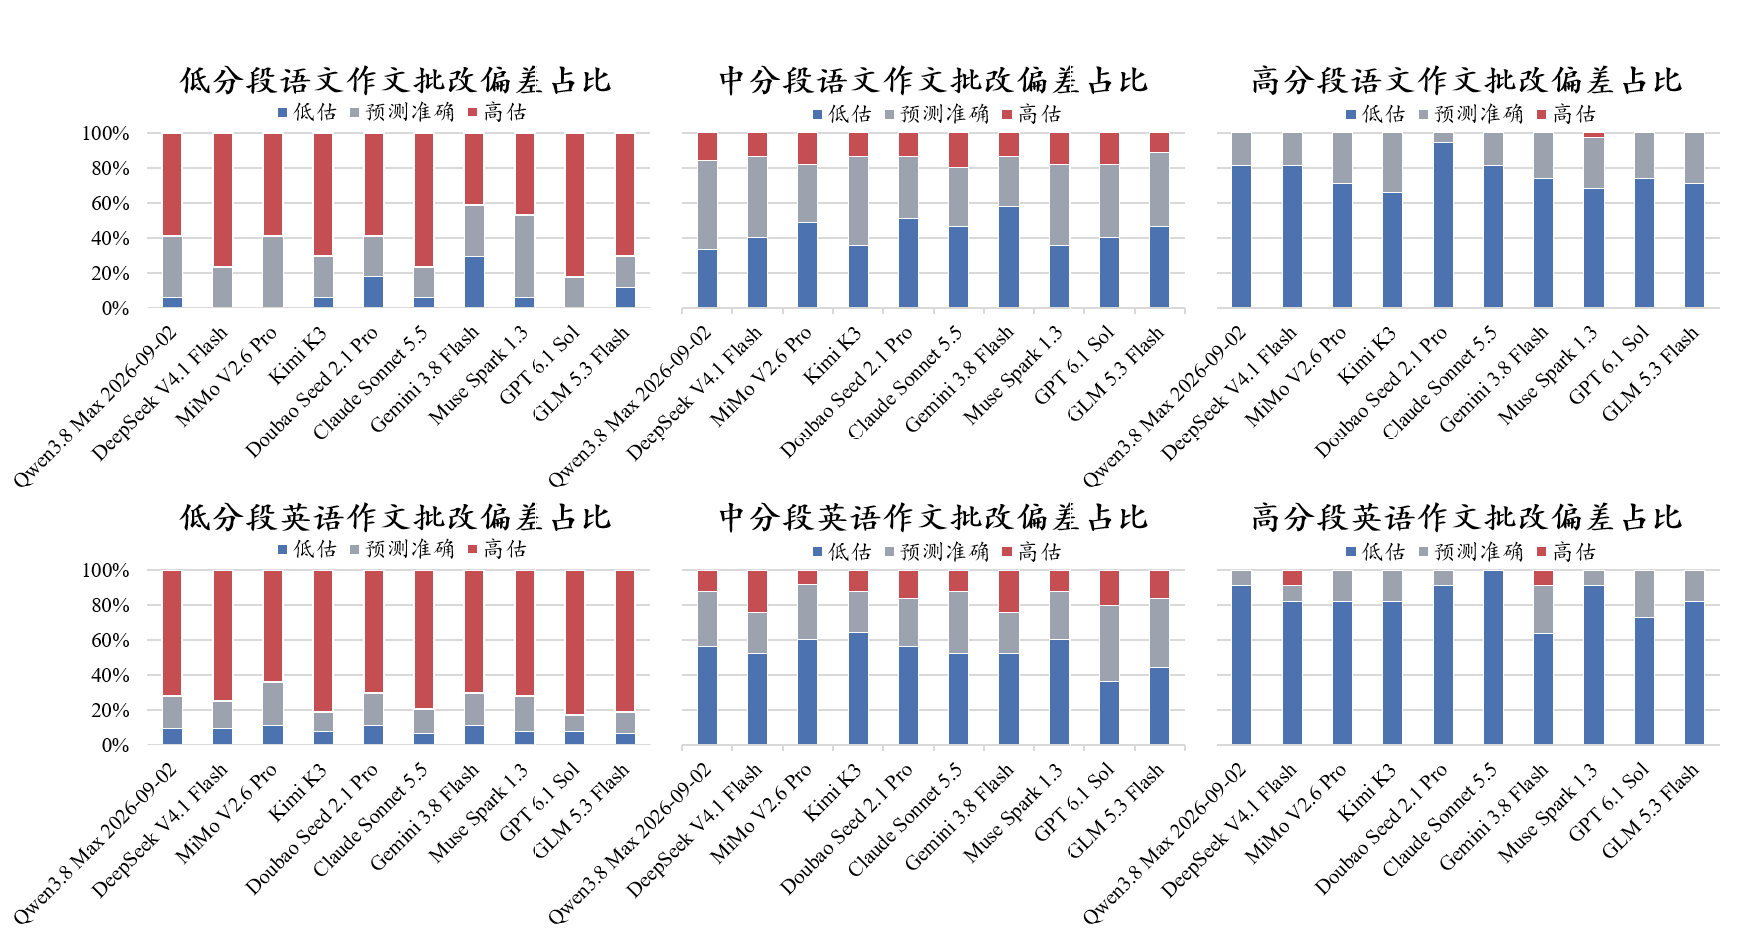
图14 低分段/中分段/高分段作文批改偏差(批改分 – 金标)占比可视化
(2)本期参评模型在语文作文低分段的各评分维度上均有所提升,但审题准确、记叙文选材恰当和情感真挚等维度仍相对不足。相较于三期,本期低分段审题准确、记叙文选材恰当和情感真挚三个维度的均分分别提升6.72分、4.13分和4.07分,达到75.18分、67.27分和76.64分,但仍低于本期中、高分段的得分。需进一步加强对题目要求、文章主旨及选材与主题关联性的综合判断能力。
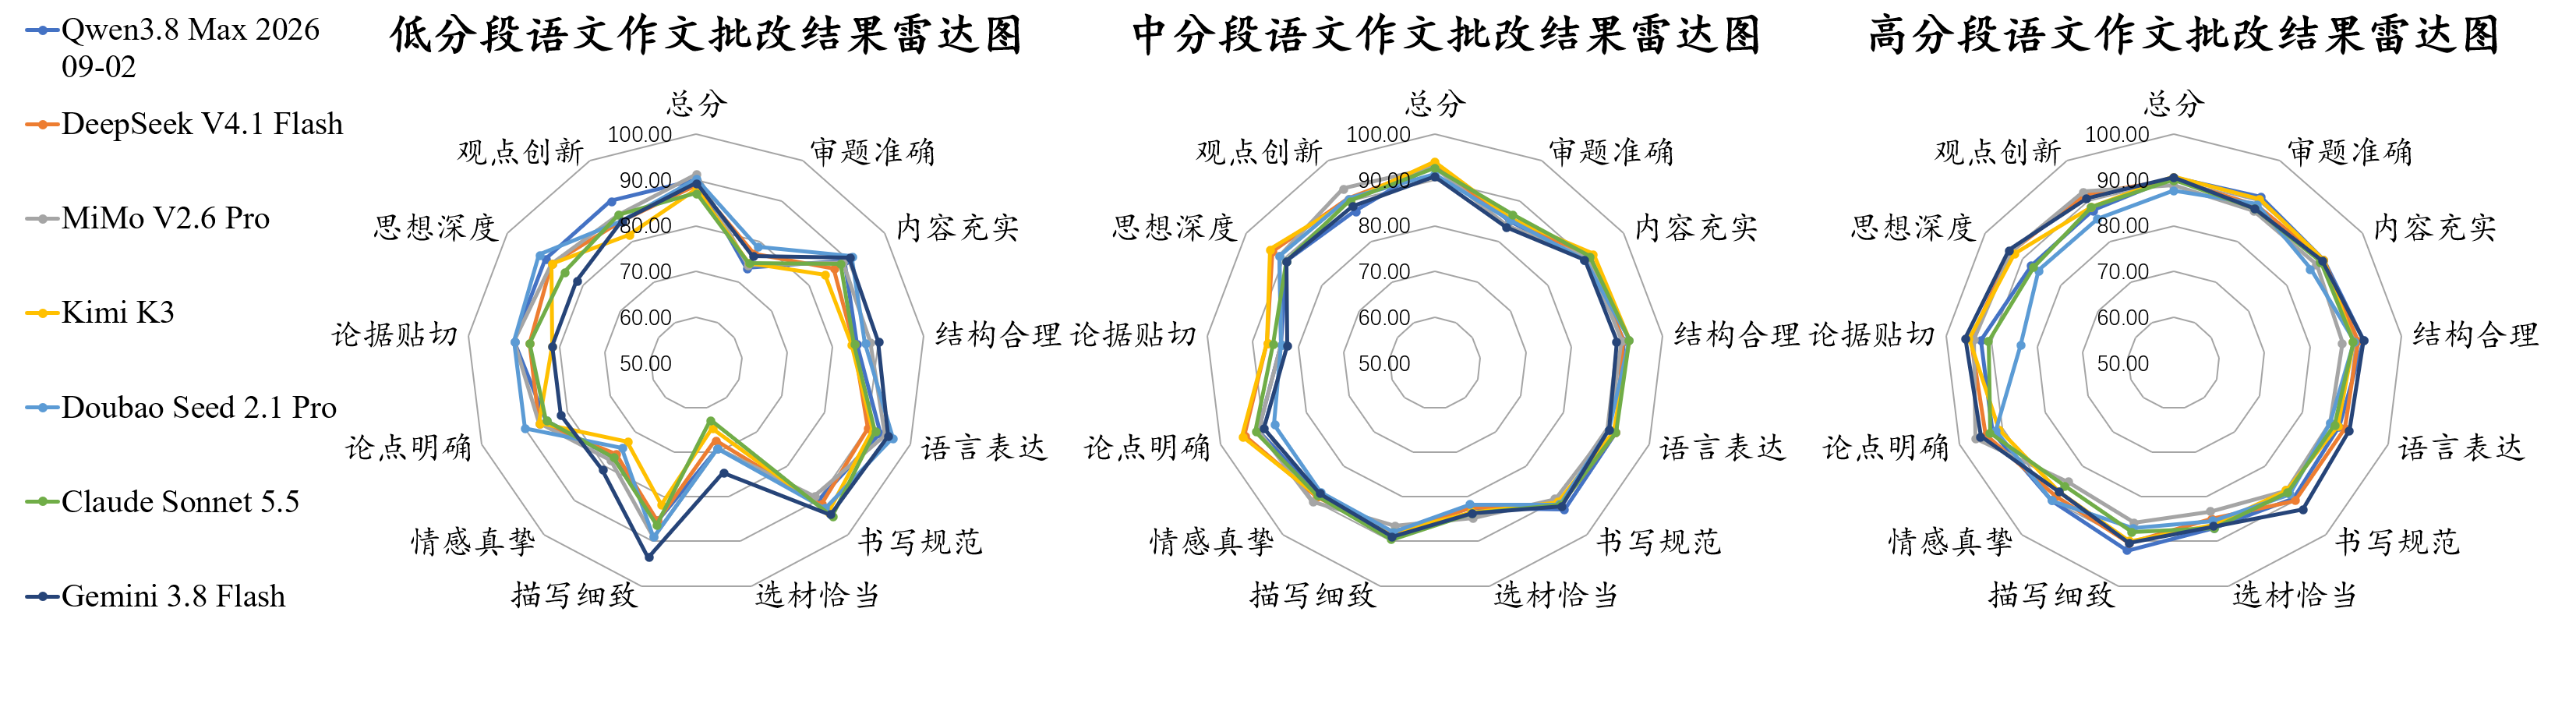
图15 作文批改部分评测结果可视化展示
(3)细粒度纠错仍是作文批改中的主要短板,模型对不同类型错误的识别能力存在差异,文本输入的纠错表现整体优于图片输入。本期模型在语文错别字、英语拼写错误等方面的检出能力有所提升,但对缺词、多词、错词等需要结合上下文判断的错误仍存在漏检。相比图片输入,文本输入能够减少手写字迹、版面解析及文字识别误差对纠错结果的影响,但模型对复杂语言错误的判断与定位仍存在不足。需进一步提升作文图片识别质量,以及模型对上下文相关错误的发现与定位能力。
附件 “北极星”基础教育大模型评测场四期评测详细结果
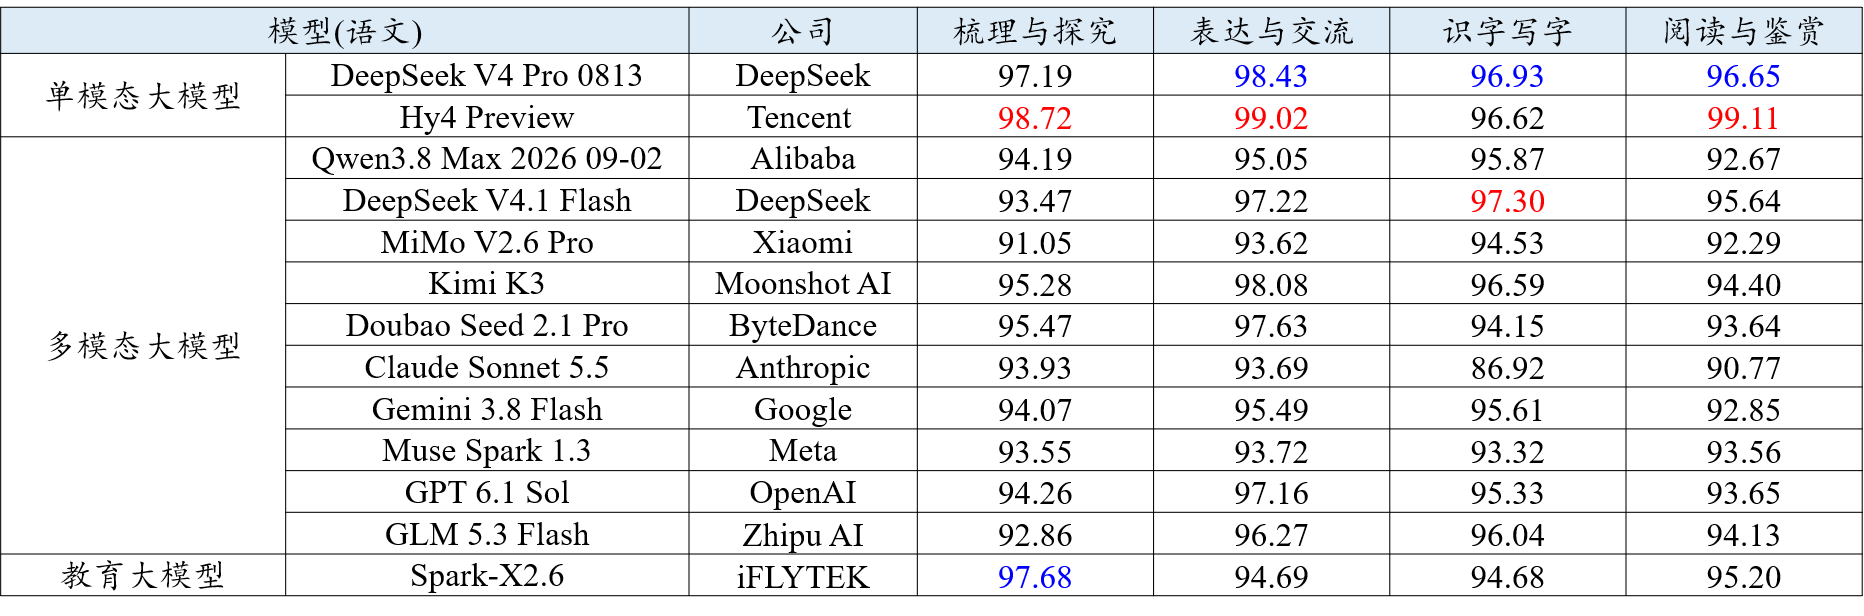
表A1 语文学科智能解题的评测结果
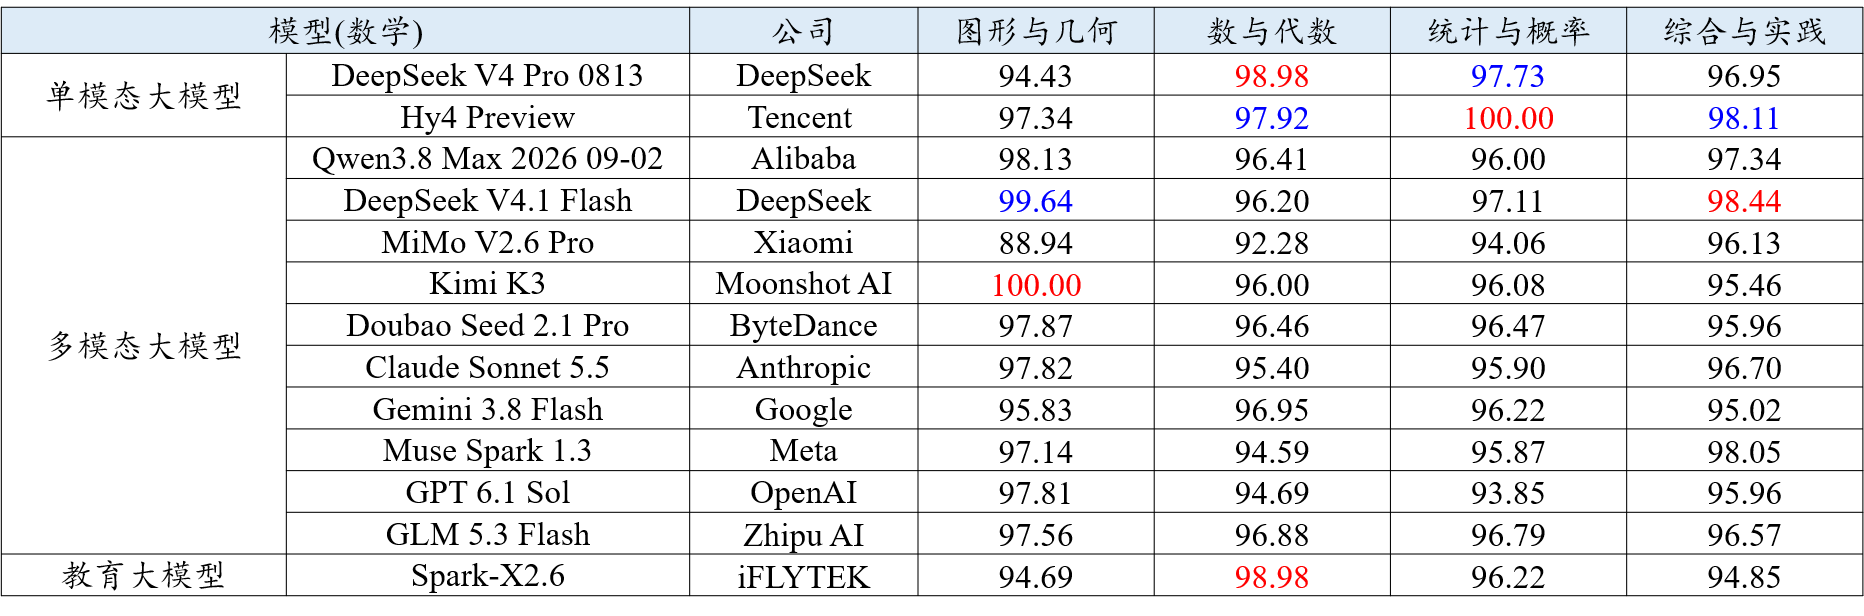
表A2 数学学科智能解题的评测结果
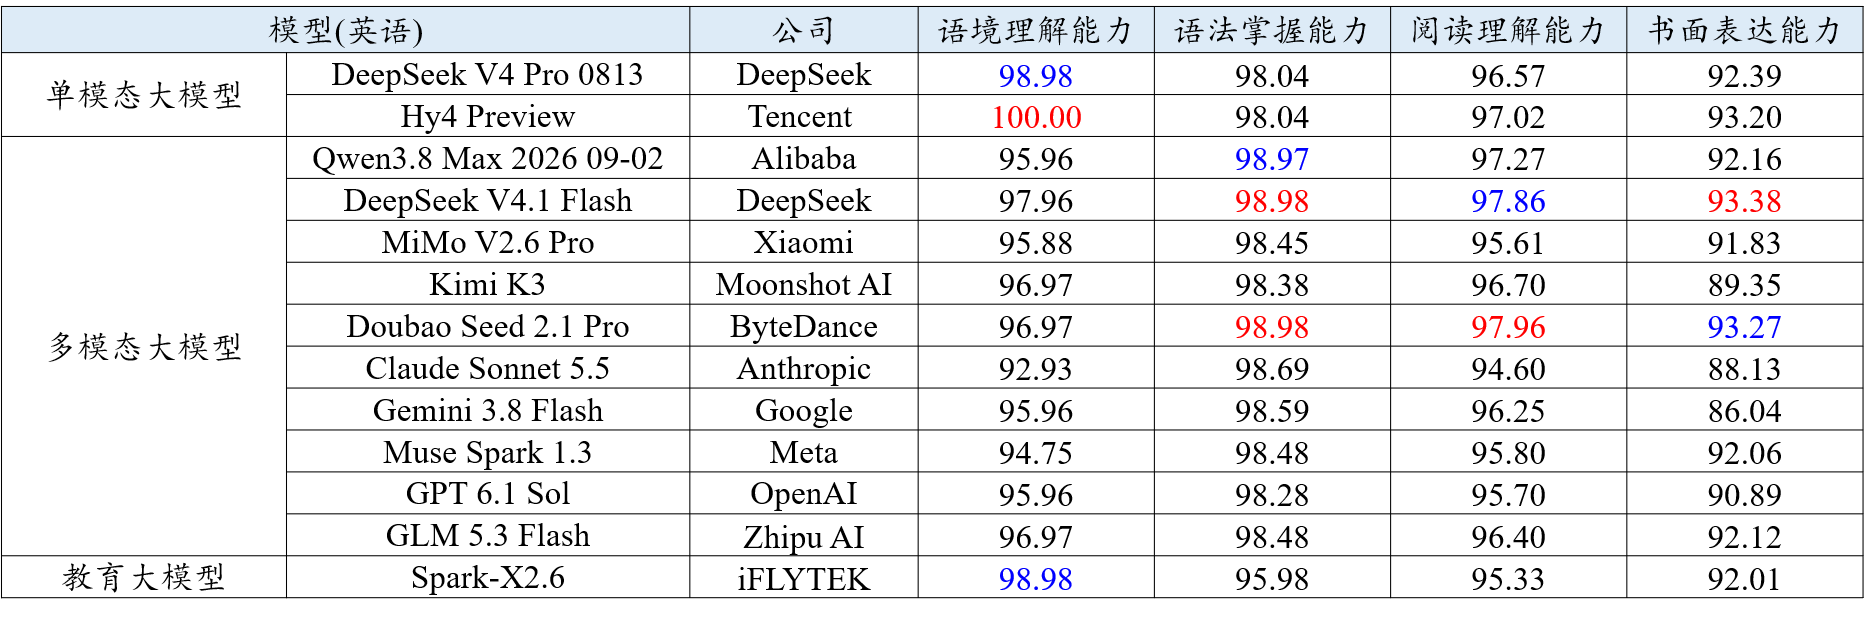
表A3 英语学科智能解题的评测结果
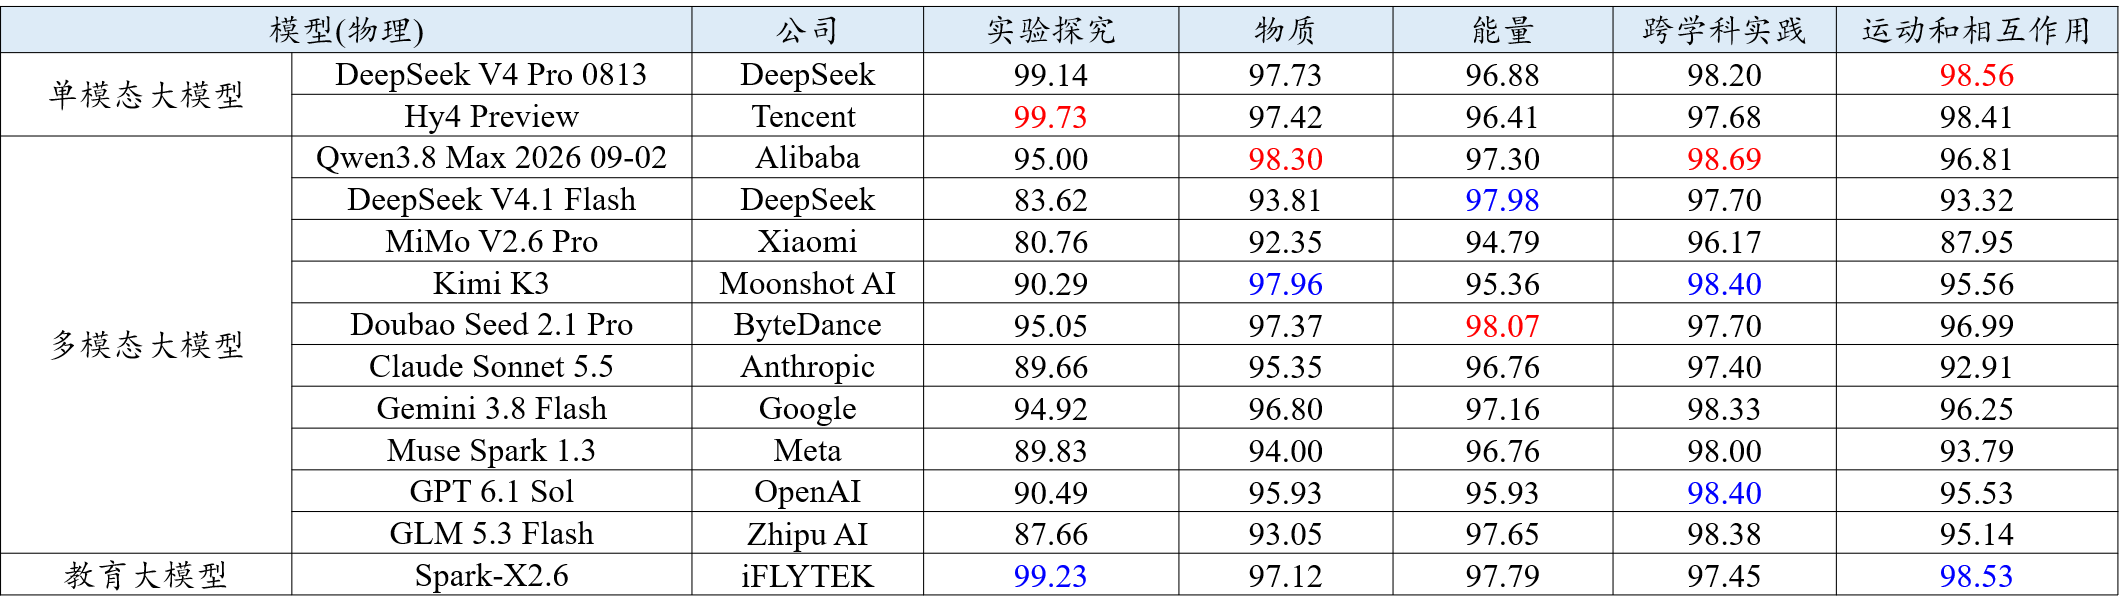
表A4 物理学科智能解题的评测结果
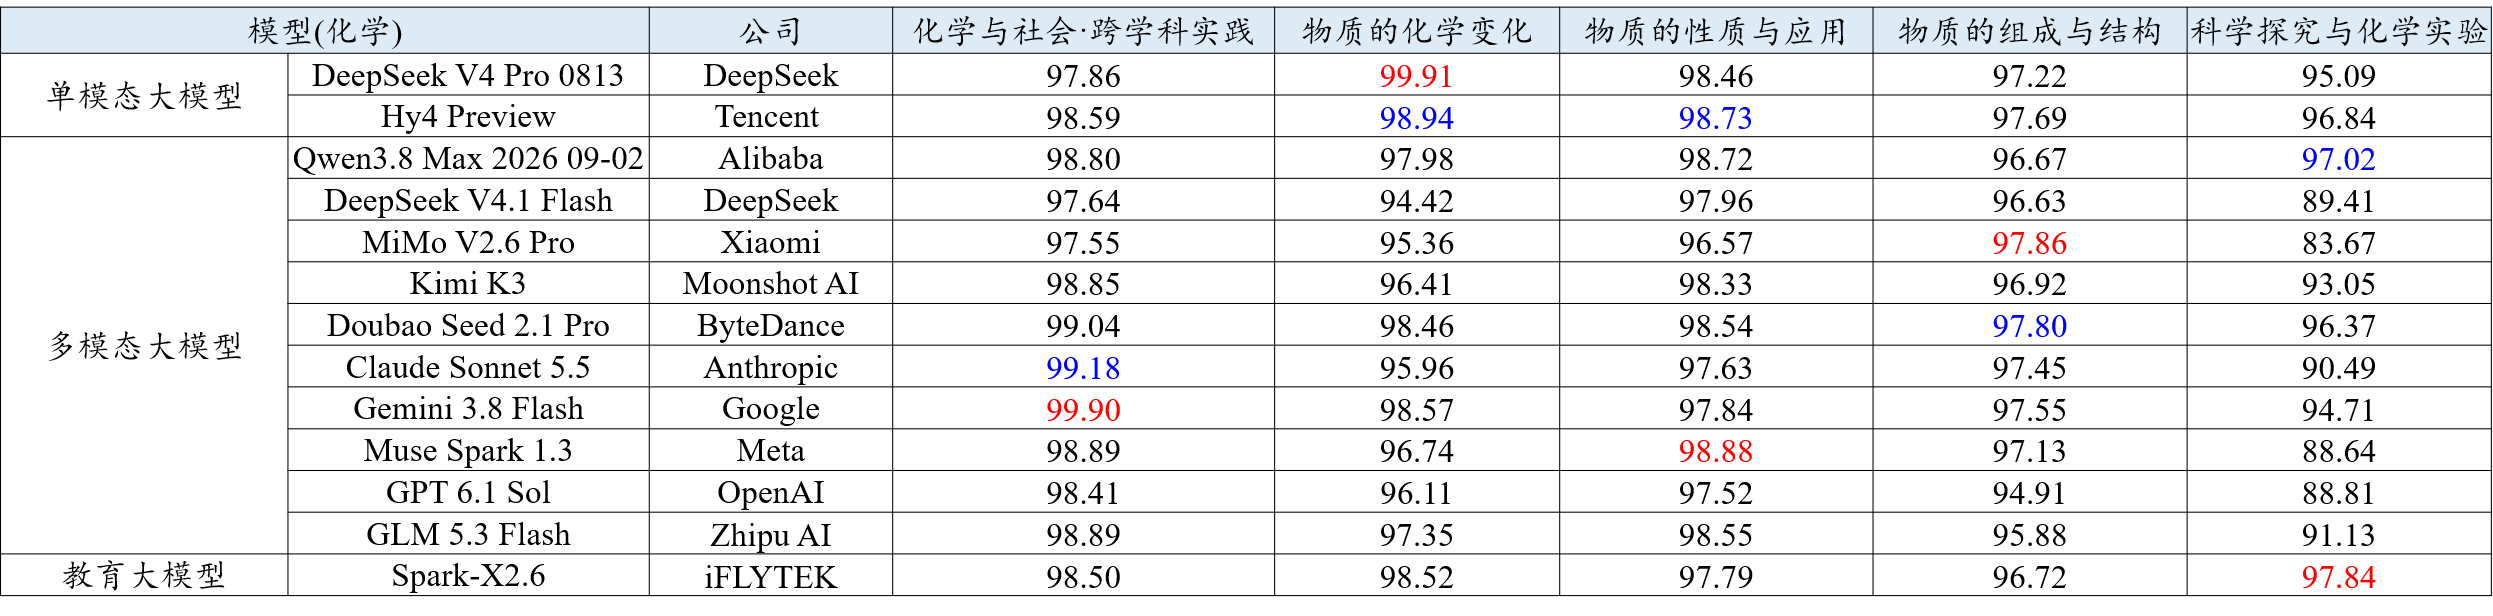
表A5 化学学科智能解题的评测结果
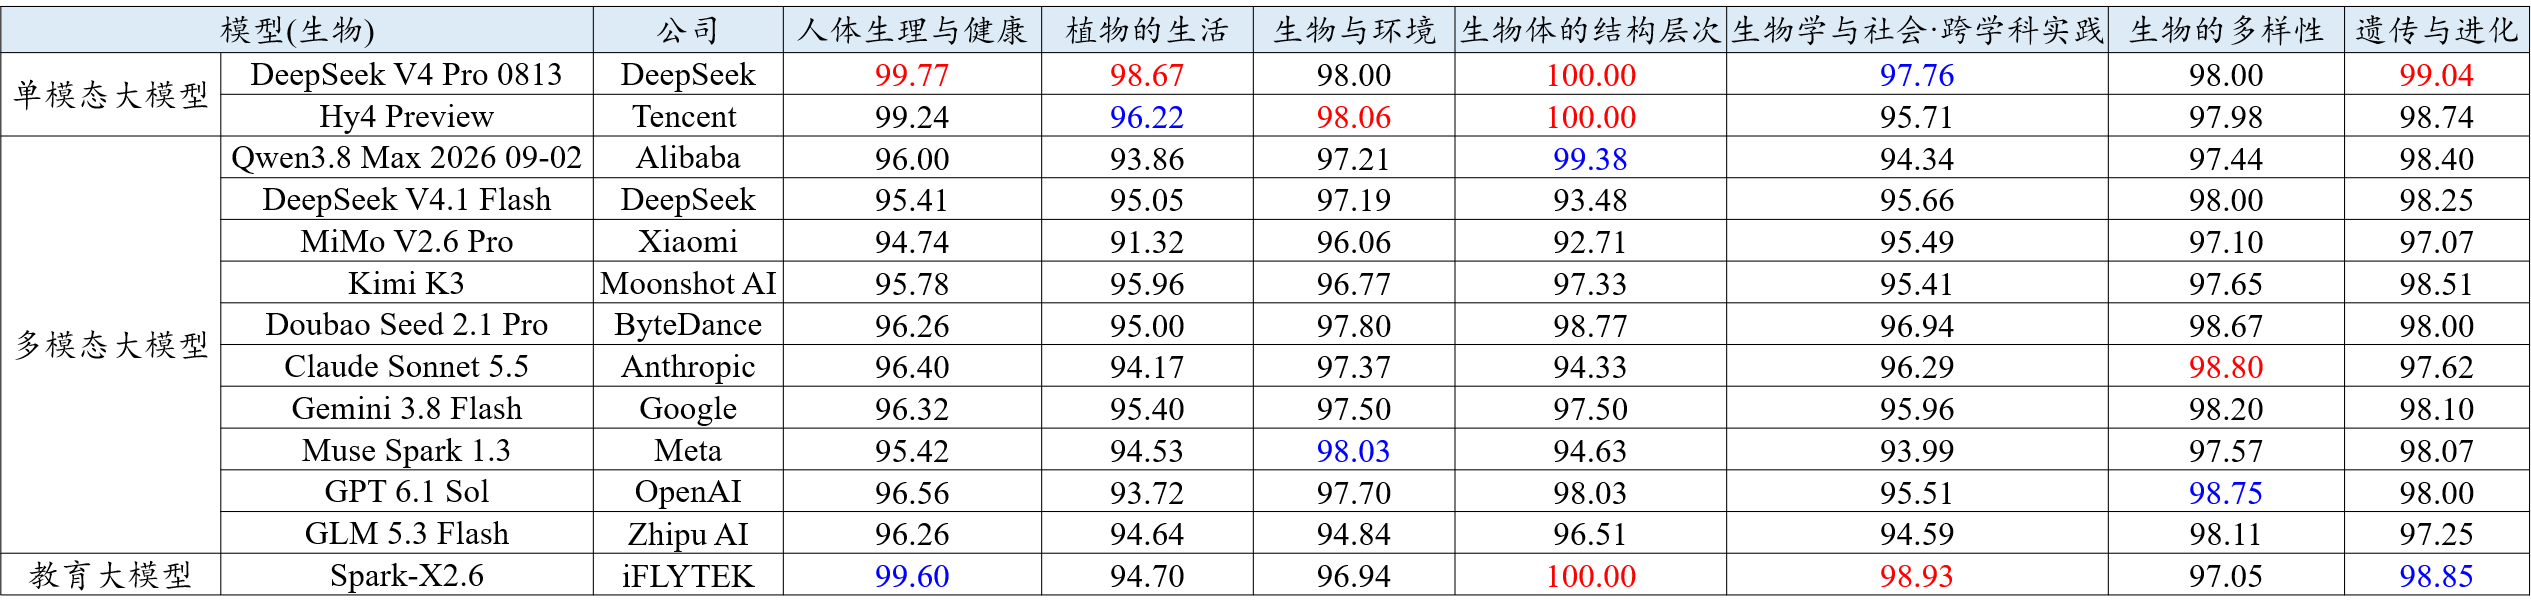
表A6 生物学科智能解题的评测结果
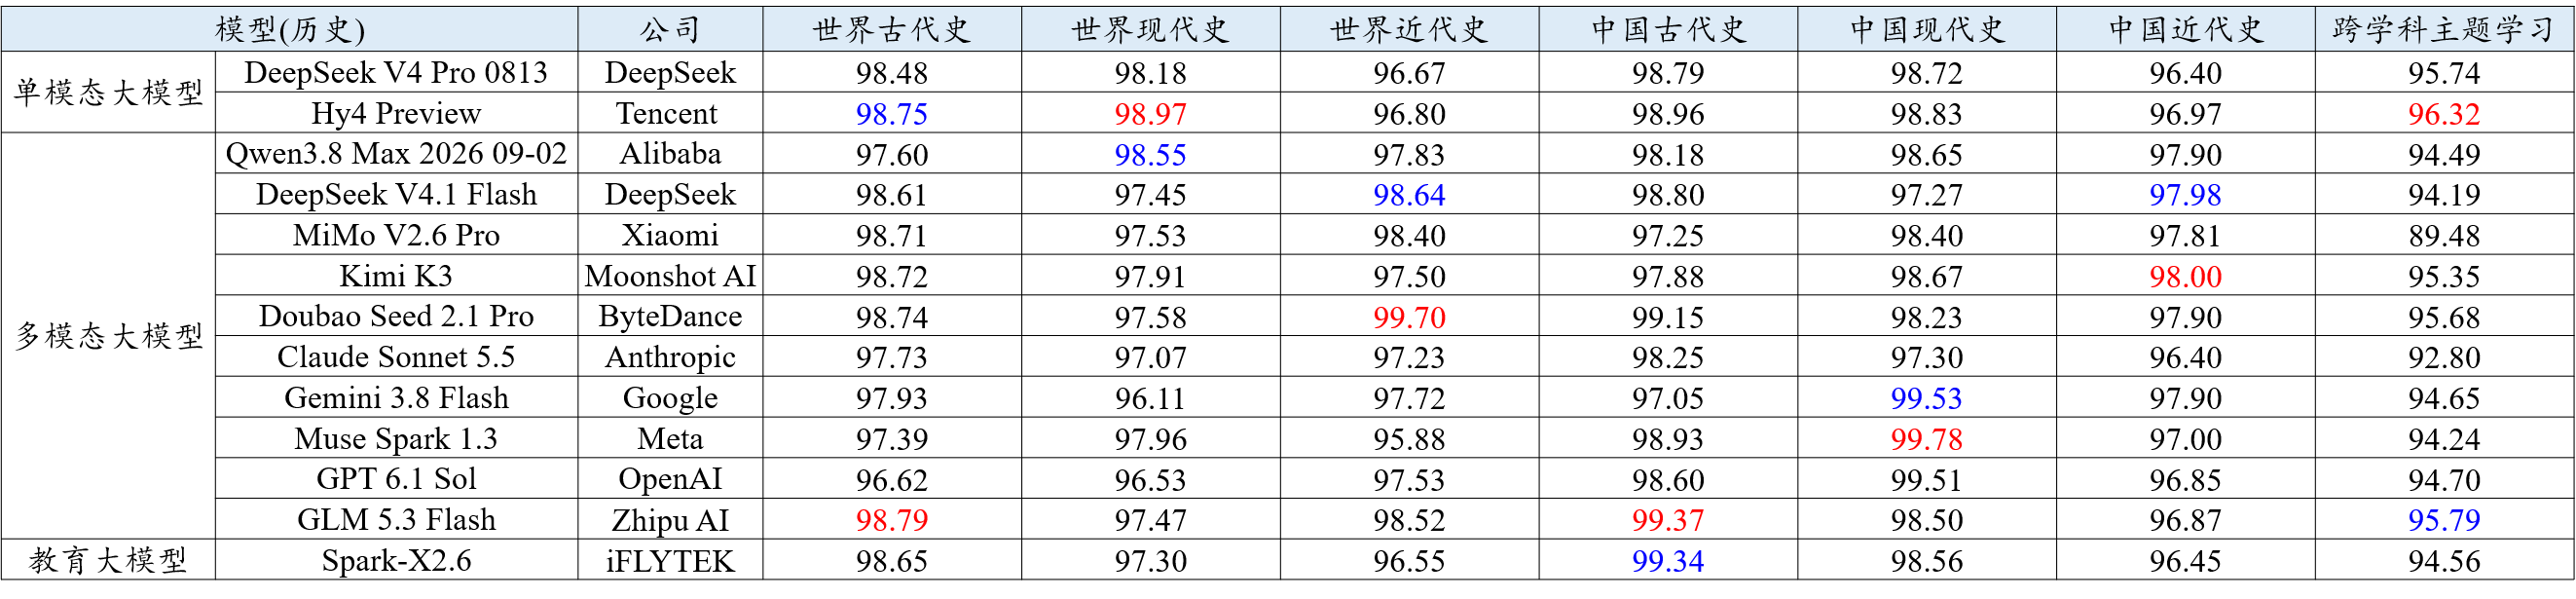
表A7 历史学科智能解题的评测结果
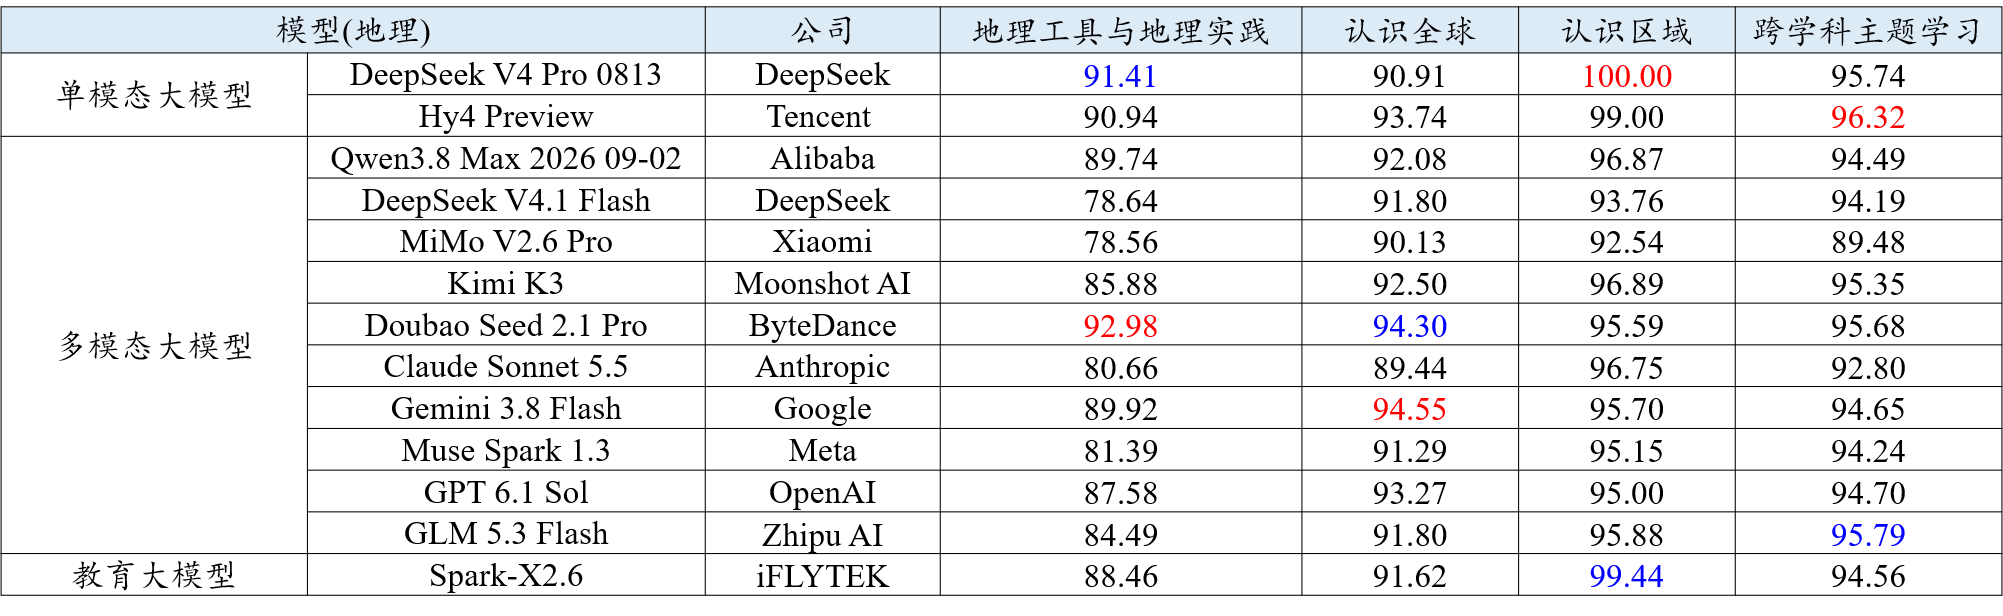
表A8 地理学科智能解题的评测结果
表A9 数学/物理/化学学科智能答疑的评测结果
表A10 数学/物理/化学学科智能出题的评测结果 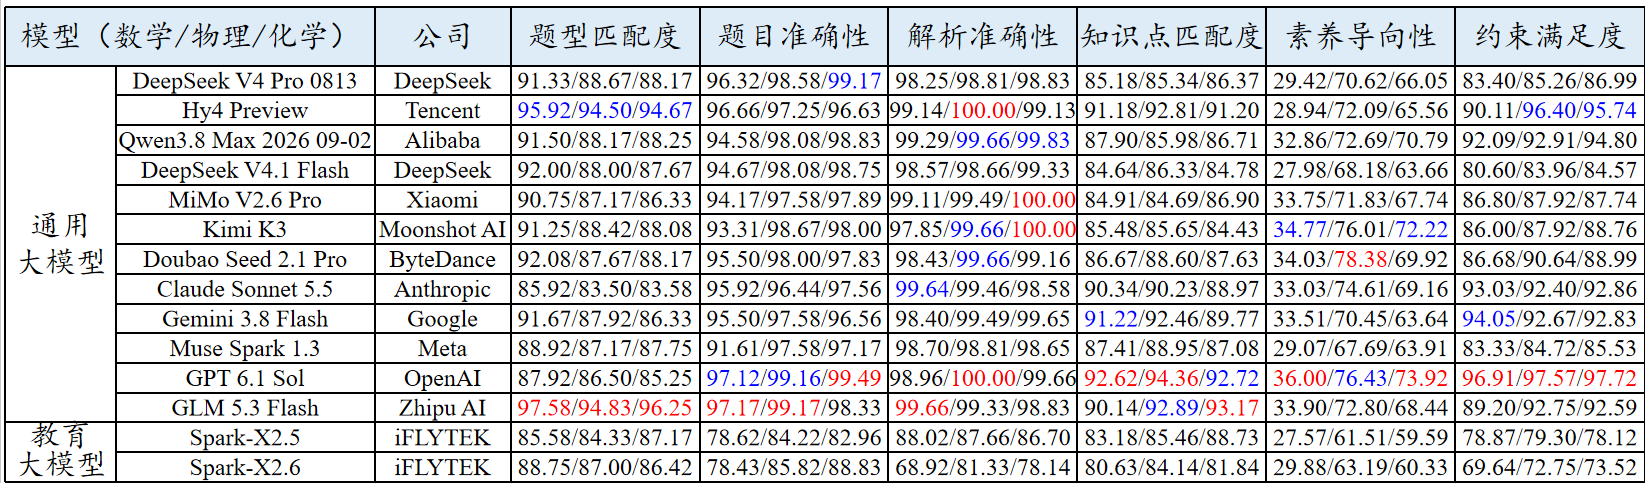
表A11 数学/物理/化学学科教案生成的评测结果
表A12英语学科口语练习的部分评测结果
表A13语文学科作文批改的总分、通用维度评测结果
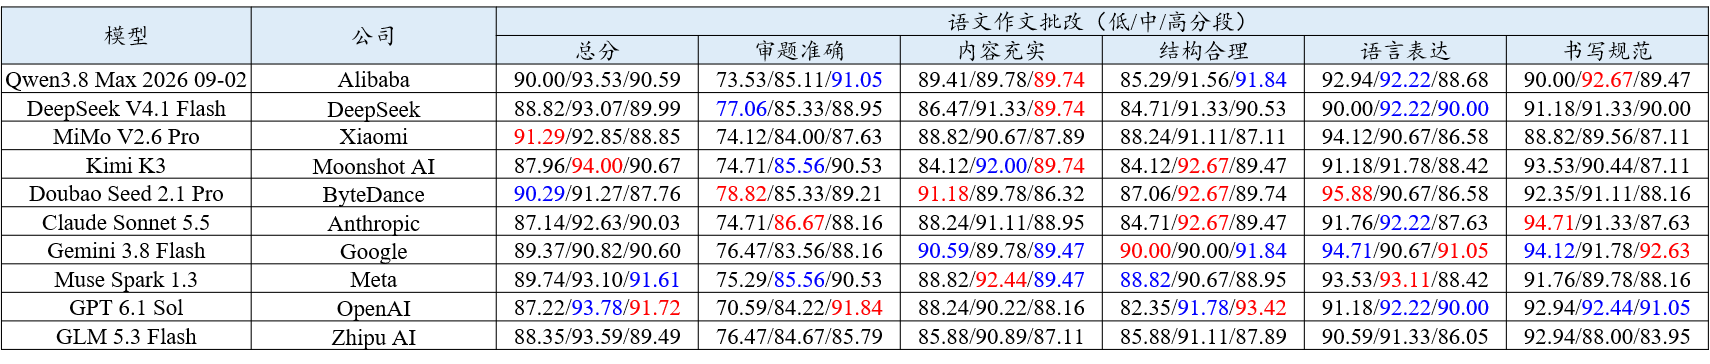
注:表中“低/中/高分段”指依据人工评分将作文样本划分为低分作文、中等分作文和高分作文三个档位,数值按“低分段/中分段/高分段”顺序展示。
表A14 语文学科作文批改的文体专项维度评测结果
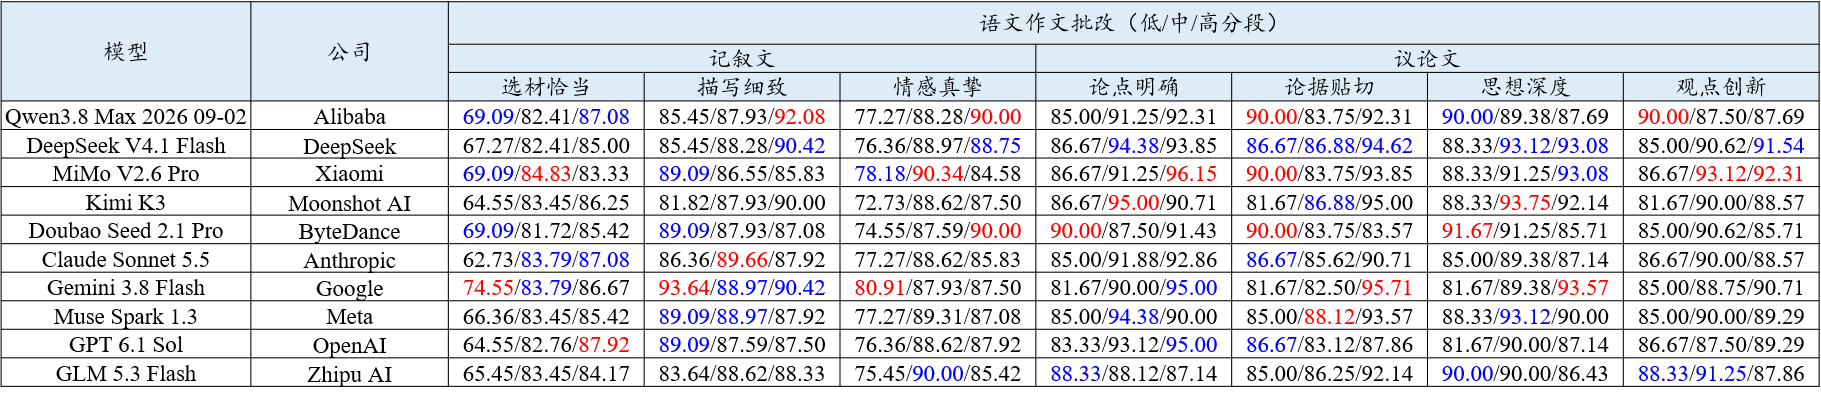
注:表中“低/中/高分段”指依据人工评分将作文样本划分为低分作文、中等分作文和高分作文三个档位,数值按“低分段/中分段/高分段”顺序展示。
表A15 语文学科作文批改的细粒度纠错评测结果
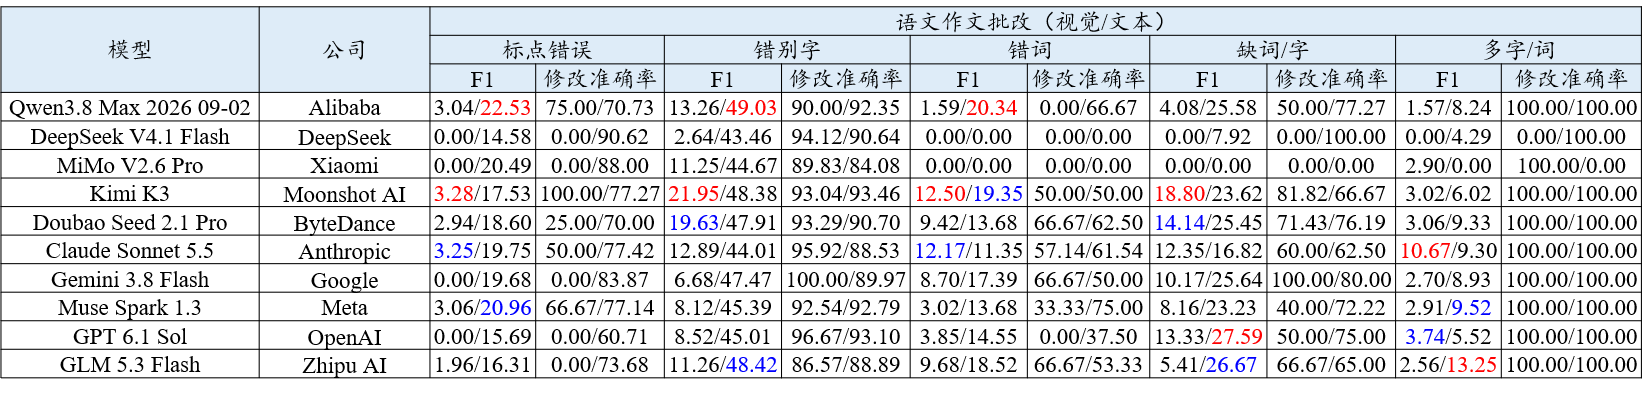
注:细粒度纠错表中“视觉/文本”表示模型分别基于作文图片和作文文本输入完成纠错任务。
表A16 英语学科作文批改的整体评测结果
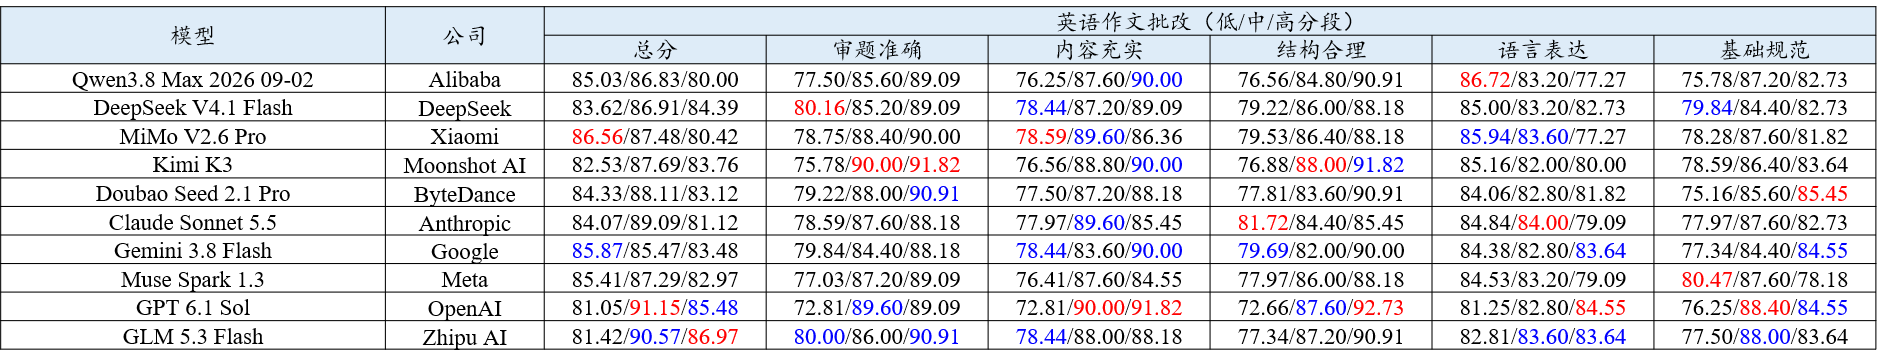
注:表中“低/中/高分段”指依据人工评分将作文样本划分为低分作文、中等分作文和高分作文三个档位,数值按“低分段/中分段/高分段”顺序展示。
表A17 英语学科作文批改的细粒度纠错评测结果
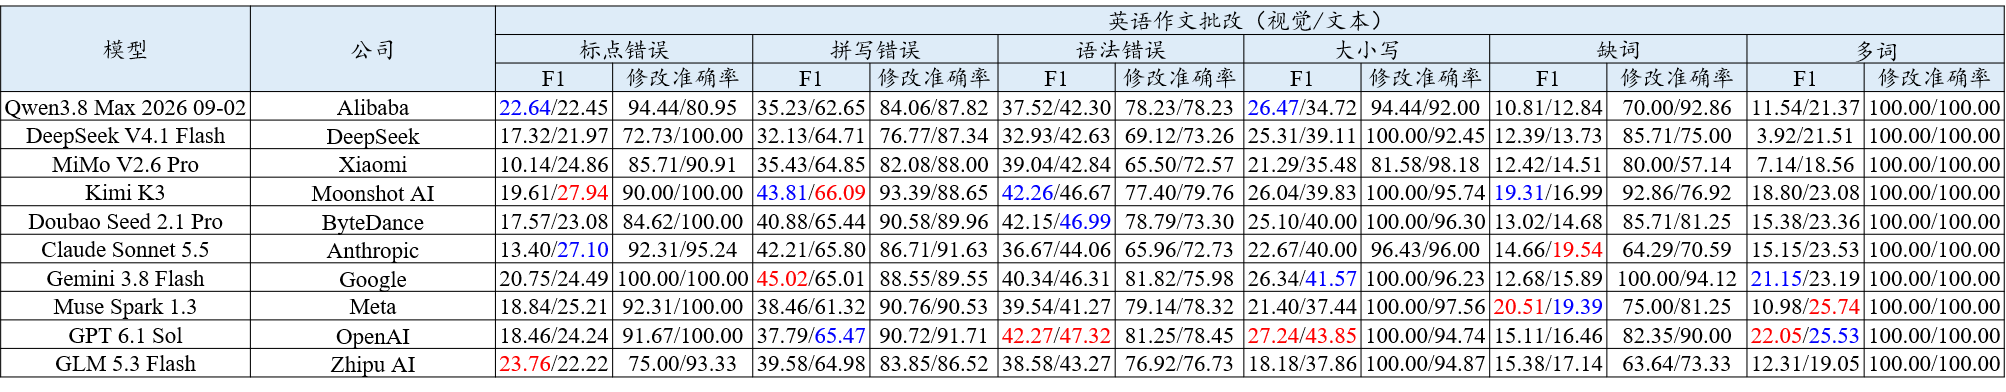
注:细粒度纠错表中“视觉/文本”表示模型分别基于作文图片和作文文本输入完成纠错任务。